11 / Diffusion
如果城市布局需要被修改,它就像一个视频问题
Urban Diffusion 更适合作为早期 video diffusion 交付物和空间生成草图来读,而不是已验证的城市规划研究结果。
旧标题容易让读者期待完整 urban-planning research,但公开证据主要支持 video diffusion / generative vision artifact。
文章只保留 3D U-Net、GaussianDiffusion、sampling / GIF pipeline 和空间连续性这类有证据的技术线索。
它可以作为早期 diffusion 背景和后续 PhysiBuilder/1shanai 的前史,不能写成已验证城市规划模型。
Core Claim
一个城市布局看起来是静态的,直到有人要求改出另一个版本。
某个街区要从商业改成居住,路网还要保持连通;公园应该扩大,但不能吞掉滨水步道;生成系统可以给出替代方案,但这些替代方案不能像彼此无关的画。道路、地块、边界和用地类别必须在局部变化中保留足够连续性,人才有办法检查它。
这就是 Urban Diffusion 这个旧项目标题里真正有价值的问题。不过,今天能验证的证据支持的是一个更小、也更诚实的结论:它是一个早期 generative vision / video diffusion 交付物,围绕 3D U-Net 和 Gaussian diffusion 学习如何把一段 frame sequence 当作被去噪和采样的对象。城市规划方向可以作为系统假设来理解:如果城市布局被表示成结构化视觉状态,模型采样就应该保留足够空间连续性,让输出能被操作,而不是只能被观看。
这个项目的作品集价值也在这个边界里。它处在静态 image generation 和 controllable spatial generation 的交界处。Image diffusion 追求一个可信 frame,video diffusion 追求一段连续 sequence;城市布局则需要相邻但更硬的东西:一个能变化、能保留道路和区域结构、能被检查的空间对象。现有 repo 证据到达 video diffusion 层。urban planning 层目前是概念和展示边界,不是已经验证的实验结果。
城市图不是普通图片
城市布局可以被画成彩色地图。居住区、商业区、道路、绿地、水体都能变成像素或 mask。这让它看起来像一个普通 computer vision 对象:模型接收布局,加噪,去噪,再生成一个更干净或不同的布局。
问题是,城市图从来不只是图。红色区域贴着道路,不只是一个红色块,它暗含可达性;绿色 corridor 不只是好看的颜色,它可能连接公园、水边和步行路径;道路线不只是边缘,它必须足够连通,才能支持移动。当生成布局改变一个街区时,它可能顺手破坏了原本让规划可用的结构。
所以,这个项目标题指向的真实技术问题是:一个有用的 urban fabric generator 必须在改变局部形态时保留结构。它要采样替代方案,但不能忘记输入布局;它要暴露 inspection surfaces,例如 land-use balance、road connectivity、green coverage,甚至 block topology 或 accessibility。规划者不会因为输出第一眼看起来合理就相信模型。他们会问:哪里变了,什么保持连通,哪些约束被破坏?
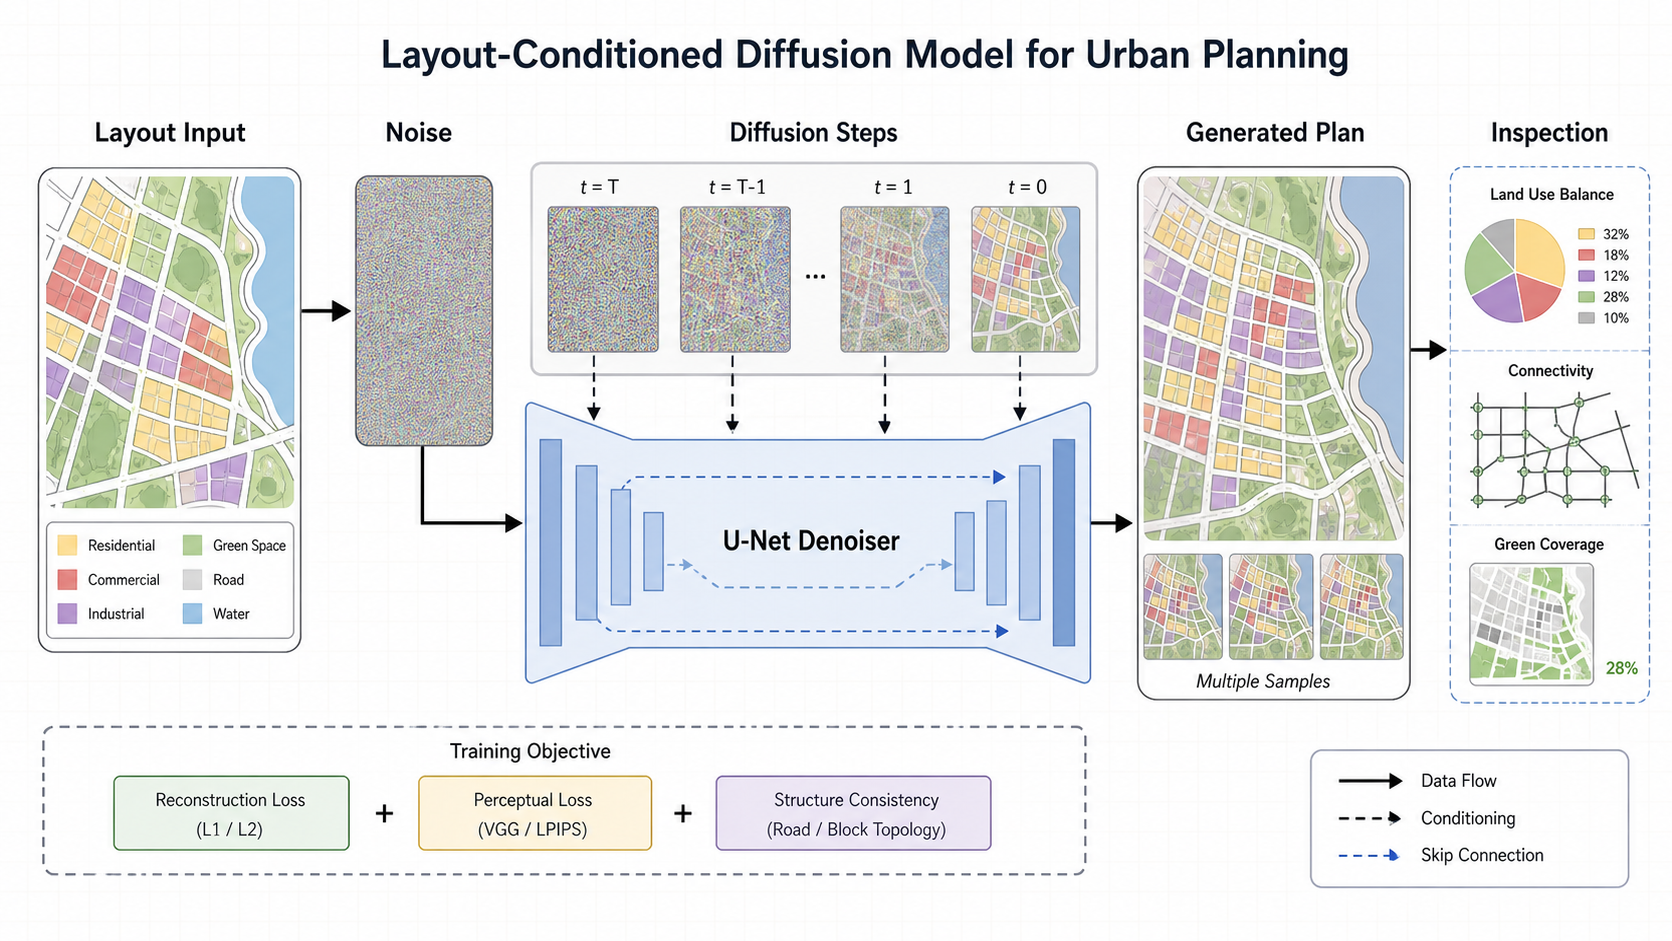
当前公开材料中的 pipeline 图表达了这个方向:layout input、noise、denoising steps、U-Net denoiser、generated samples,以及 land-use balance、connectivity、green coverage 这些检查面。作为概念图,它命名了正确的系统组件;作为证据,它必须谨慎使用。我没有找到与这张图配套的训练日志、城市数据集、评测脚本或生成 benchmark。因此它支持的是 idea,不是完整 urban-planning model。
这个区别改变了叙事。Urban Diffusion 最稳妥的经验是:空间生成需要一个可检查的中间对象。城市布局可以是 visual tensor,但真正的工作开始于这个 tensor 被绑定回规划义务:连通性、平衡、覆盖、邻接和可编辑性。
为什么 video diffusion 仍然是有价值的学习入口
公开 repo 名为 urban-planning-diffusion-pytorch,但 GitHub 标记它 fork 自 lucidrains/video-diffusion-pytorch。README 呈现的是基于 Video Diffusion Models 的 PyTorch video diffusion 实现:Unet3D、GaussianDiffusion、text conditioning、GIF training、sampling,以及 Moving-MNIST 或 fireworks 风格示例。
这件事很重要,因为 video diffusion 引入了单张 image generator 容易隐藏的维度。video tensor 有 batch、channel、frame、height 和 width。模型不能把每一帧都当成孤立图片,否则 sequence 会不连贯。repo 里的 architecture 使用 3D convolutional structure 和 spatial / temporal attention,再把 denoiser 包进 Gaussian diffusion process。
对早期生成系统项目来说,这是一个合理的学习目标。2D image generator 教的是从噪声到图像的基本思想;video generator 教的是生成对象内部有连续结构时会发生什么。Urban fabric 有类似压力,虽然它的轴不一定是时间。一个 plan 可能有 current layout、noisy proposal、intermediate denoising states、sampled alternatives 和 edited variants。重点是变化中的连续性。
3D U-Net 是这里的核心机制。普通 image U-Net 通过 downsampling 压缩空间信息,再通过 upsampling 和 skip connection 重构。video U-Net 扩展这个模式,让表示包含 frame 维度。模型可以用 spatial attention 处理单帧结构,用 temporal attention 处理跨帧一致性。这就是 video diffusion 区别于 image diffusion 的基本工程动作:它学习去噪的是一个带内部 sequence structure 的对象。
GaussianDiffusion 则提供训练和 sampling 契约。训练时,系统按照 schedule 给输入加噪,denoising network 学习预测 clean signal 或 noise component。sampling 时,过程反向运行,从噪声开始,反复调用 denoiser,直到得到 video-shaped output。repo 也暴露 text-conditioning 路径,包括 learned conditioning dimensions 和 BERT-based text conditioning options。
如果要把它真正改造成 urban-layout diffusion,这个契约需要更强 conditioning。layout-conditioned diffusion model 应该接收结构化输入,例如 parcel map、zoning mask、road graph raster 或 scene-like representation。denoising network 要在采样替代方案时保留输入约束,inspection layer 再用规划相关指标检查生成布局。现有证据没有显示这个完整 adaptation 已经完成,但它说明为什么 video diffusion code path 是理解问题的合适入口。
这个交付物真正生成的是什么对象
读这个项目最有用的方式,是问模型到底在生成哪类对象。
image generation 的对象是一帧图。video generation 的对象是一小段序列。layout generation 的对象则应该更接近结构化视觉状态:带类别、边界和关系的 map-like arrangement。结构越强,越不能只用视觉真实感判断输出。
repo 代码指向三个相关思想。
第一,denoiser 同时处理空间和时间。Unet3D 的实现包含 temporal attention、spatial attention、residual blocks、downsampling、upsampling 和 relative position bias。这说明 architecture 围绕“frame 之间有关联”组织,而不是生成一堆无关图片。
第二,diffusion wrapper 让 sampling 成为过程,而不是一次性预测。这对可操作性很重要。采样对象可以在最终结果处检查,也可以在中间状态检查:noisy input、denoising steps、predicted clean signal 和 final sample。如果存在完整 urban 版本,这些中间状态可以帮助 debugging。断开的路网可能在去噪过程中逐渐出现;land-use imbalance 可能说明 conditioning 不足、训练数据偏差或 inspection constraint 缺失。
第三,训练 interface 假设数据可以组织为 GIF 或 video-like tensor。这是实践细节,也有概念后果。要训练模型,世界必须被打包成重复形状。对 video 来说,这个形状是 frames;对 urban layout 来说,对应包装可能是 land-use layers、road masks、height maps、城市演化时间步,或者同一 base condition 下的多个方案。
这个包装决定模型能学什么。如果道路和 land use 被压成普通 RGB 图,模型可能学视觉纹理而忽略 topology。如果 layout 用显式 channel 表示,并用外部指标检查,模型才更可能保留 planning-relevant structure。旧项目没有足够证据说明这已经实现,但它确实提供了从 video diffusion 走向 controllable spatial generation 的自然桥梁。
pipeline 图提供的是方向,不是结果
网站资产里的 urban-diffusion-pipeline.png 比公开 repo 更有野心。它展示的是 layout-conditioned diffusion model for urban planning:左侧是彩色城市地图,中间是 noise、diffusion steps 和 U-Net denoiser,右侧是 generated plan samples 和 inspection panel。
我认为图里最重要的是 inspection panel。Land-use balance、connectivity 和 green coverage 是正确的检查对象,因为它们不是纯审美指标。它们问的是生成图是否还像一张规划图。它们也暴露了严肃版本需要补上的部分:数据集、land-use 和 road structure 的表示、conditioning scheme、objective functions 或 validators,以及可以和 baseline 对比的评测输出。
图中的 training objective 写了 reconstruction loss、perceptual loss 和 structure consistency。这是合理的设计方向,但应该被描述为方向。我没有找到本地代码或日志实现这些 urban-planning losses。公开 repo 的主要训练路径是 video/GIF diffusion。因此,这张图更像 conceptual system sketch,而不是 completed experiment 的证据。
把边界讲清楚反而让交付物更有用。弱证据被夸大时会变混乱;被放在正确位置时,它能说明一个思想来源。这里的思想是:spatial generators 只有在生成对象仍然可检查时,才更可能成为工具,而不只是图片生成器。
结果应该如何定位
可验证结果是代码和概念交付物,不是经过评测的 planning model。
代码侧,公开 repo 展示了 video diffusion 的机制:3D U-Net、Gaussian diffusion sampling、text-conditioning examples,以及 GIF-like data 的 training interface。它也包含 3d-unet.png、fireworks.webp 等 sample assets 和 README usage examples。GitHub 将 repo 标记为 fork,公开采用信号也很弱,这更适合被视为个人学习和备份交付物,而不是已有外部 adoption 的研究包。
概念侧,网站页面和 pipeline image 把 diffusion 连接到 urban layout manipulation。这个连接是有技术意义的,因为 layout generation 和 video generation 有相同张力:对象会变化,但 coherence 很重要。生成的 plan 需要被采样、检查,也可能被编辑。作为作品集里的补充项目,它能说明我早期接触 diffusion code organization、denoising schedules、sampling APIs 和 structured visual generation。
它不应该承担和论文项目、产品截图、测试、部署 workflow 或用户交付同等的证据重量。这个克制定位仍然有价值。很多更强的 generative systems 项目都从这种小技术接触开始:读懂代码路径,看清 tensor shape,理解 conditioning 进入哪里,追踪 sample 如何生成,并注意到看似视觉化的输出必须经过外部检查才能被信任。
证据边界
当前 workspace 没有恢复出 urban-planning training dataset、city-layout preprocessing scripts、model checkpoints、urban 评测指标、loss curves、绑定到 run 的 generated plan samples,或者解释原创实验的 paper/report。我也没有找到 urban-specific diffusion implementation 的本地源文件。能确认的材料主要是生成页面和 pipeline image。
公开 GitHub repo 加强了 video diffusion claim,同时缩小了 urban planning claim。它支持我写“早期 video diffusion / generative vision practice”,支持讨论 Unet3D、GaussianDiffusion、spatial/temporal attention、diffusion schedules 和 sampling/training support。它不支持写“完成了 layout-conditioned urban-planning model”。
如果这个项目要复活,升级路径很清楚:
• 定义 urban representation,例如 raster land-use channels 加 road mask。
• 收集或合成足够多样的 paired layouts。
• 实现 conditioning,让生成结果保留 base layout 或 user constraints。
• 加入 structural validators,检查 road continuity、land-use balance、green coverage 和 invalid overlaps。
• 把 generated samples、metrics、configuration 和 run logs 一起保存。
• 和 rule-based perturbations、image-only diffusion 等 baseline 对比。
这些步骤会把 concept 变成 evidence。在它们完成之前,公开说法应该保持较小:Urban Diffusion 是早期 video diffusion 实践,连接到后来对 controllable spatial generation 和可检查中间表示的兴趣。
为什么它仍然属于作品集
Urban Diffusion 不应该被包装成强成果,但它可以解释一条能力线索:我不是只从最终 demo 看生成系统,而是会问生成对象是否保留结构、是否能被检查、是否能支持后续修改。
这条线后来出现在 1shanai 的正反面服装生成里,也出现在 PhysiBuilder 的 3D scene prior 里。看起来这些项目领域不同,一个是服装,一个是 3D 场景,一个是城市布局概念,但底层问题相似:生成结果如果只是漂亮输出,它的使用价值很有限;它必须带着可检查的中间状态,才可能进入真实工作流。
因此,Urban Diffusion 在作品集里最诚实的位置是“早期生成式视觉能力线索”。它说明我接触过 video diffusion 的核心机制,也说明我很早就开始关注空间生成中的结构约束。它的边界清楚,反而让整体叙事更可信。
参考材料
- GitHub: https://github.com/ZiAngGu1/urban-planning-diffusion-pytorch
- README.md in public repo: Video Diffusion - Pytorch.
- 3d-unet.png, fireworks.webp, Moving-MNIST sample assets in repo.