01 / 法律 AI
工作框架就是产品:为法律和税务工作构建智能体
法律和税务 AI 的价值,不在于多生成一段回答,而在于把混乱客户材料整理成可恢复的工作包:案件事实、来源证据、草稿、审批边界和评测轨迹。
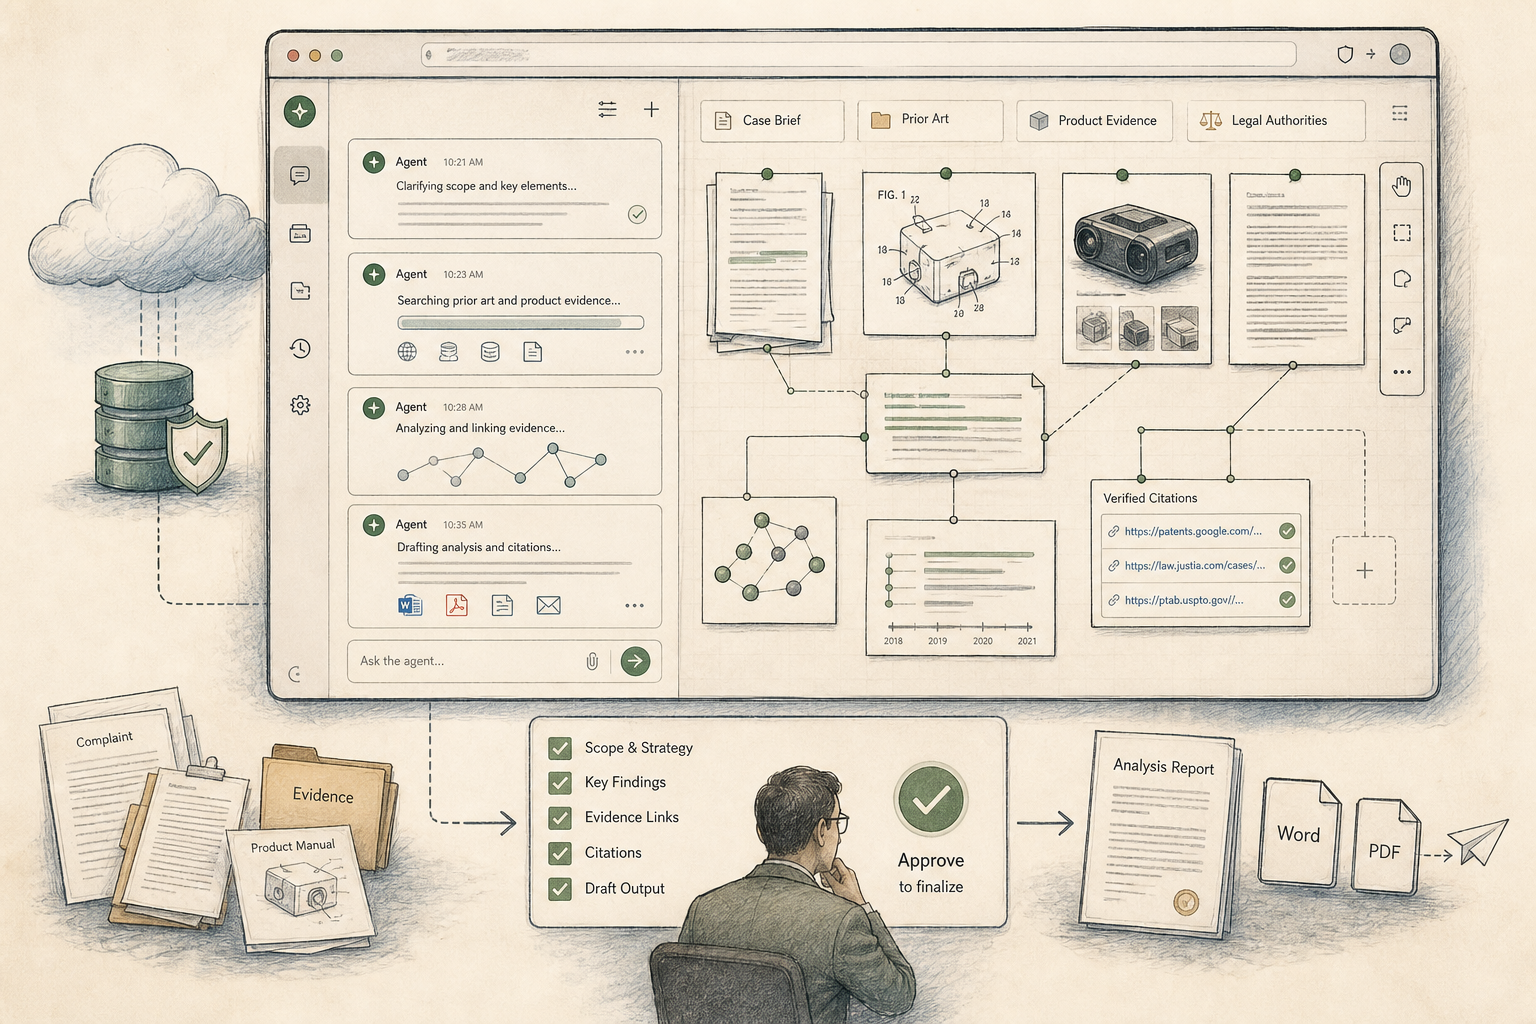
专业服务任务的瓶颈在于把邮件、材料、来源、草稿和审批整理到专家能接手的状态。
系统把信息接收、来源提取、证据矩阵、引用预检、草稿审阅和审批门做成可运行的工作框架。
内部税务流程进入 2-3 分钟审阅工作流;专利检索有 answer-blind 评测。最终法律判断仍由专家负责。
Core Claim
法律和税务 AI 最容易被误解的地方,是把“回答问题”当成了产品的终点。一个模型可以把客户邮件改写得很顺,可以把 TRO 冻结通知解释得像那么回事,也可以把专利检索结果整理成一段漂亮的风险说明。但在真实专业工作里,漂亮段落通常不是最稀缺的部分。更稀缺的是:材料有没有收齐,证据能不能复核,草稿从哪些事实来,哪些动作需要人批准,失败以后下一轮能不能接着做。
Lawless 做的不是把法律/税务工作压扁成一次问答,而是把它拆成一条可恢复、可审查、可回滚的工作带:接收案件状态,保存证据对象,生成可编辑交付物,把外部动作交给 ActionGate 和审批队列,再用评测循环维护搜索策略、输出契约和风险边界。系统真正交付的不是“智能体说了什么”,而是一包专家可以继续工作的材料。
这也是我认为专业服务智能体需要换一个评价方式的原因。它的价值不在于看起来多自主,而在于能不能把自主性限制在合适的位置:能自动读材料、检索、解析、比较、起草、整理交付物;但在发送邮件、提交立场、删除资料、联系对方或作出法律结论之前,必须停在人的判断边界上。
开场问题
想象一个税务合伙人收到客户邮件。邮件里有事实描述、附件、上一轮沟通、可能已经变化的监管来源、客户偏好的语气,还有一个压在所有人头上的截止时间。她并不需要模型告诉她“这个问题很复杂”。她真正需要的是一个工作包:哪些事实已知,哪些来源支持这些事实,哪些假设还没有验证,草稿该怎么写,哪些地方需要专家拍板。
同样的压力会出现在跨境电商卖家的 TRO 场景里。卖家看到资金冻结通知,担心店铺资金被锁、商品被指控、平台要求回应、律所邮件催促和解。用户问“我该怎么办”时,快速给建议很诱人,但这是系统最该慢下来的地方。一个有用的工作流要先保存案件来源、冻结金额、被诉商品、缺失材料、响应路径、结算可能性和邮件草稿,而不是跳到一个像法律意见的结论。
专利检索把这个问题放得更尖锐。一个产品链接、产品图、专利标记或 Google Patents 页面,可能指向真实的高风险专利,也可能只指向同族成员、历史记录、外国专利、过期专利或技术相邻但风险较弱的记录。幻觉当然危险,另一种更安静的危险是:报告写得很顺,却把审查者最该先看的专利埋在一堆 RELATED 里。
这些场景共享一个核心问题:法律和税务智能体要不要把“通向答案的路径”也当成交付物?Lawless 的答案是要。只有路径可见,专家才知道系统为什么这样写、哪里需要补证、哪里不能越界。
核心论点:可控的工作带比裸自主更重要
一个专业服务智能体至少需要五条带子。
| 工作带 | 作用 | 失败时暴露的问题 |
|---|---|---|
| 接收带 | 把客户材料、上传文件、问卷答案、区域设置和案件类型转成案件状态 | 系统不知道自己在处理什么类型的专业工作 |
| 证据带 | 把来源、引用、专利记录、claim/status、平台截图和附件变成可复核对象 | 结论看似成立,但证据链断了 |
| 草稿带 | 把输出变成专家可以编辑、批注和继续加工的交付物 | 回答好看,但不能进入真实工作流 |
| 审批带 | 用 ActionGate、审批队列和草稿文件夹限制外部动作 | 系统把阅读、起草、发送、提交混成同一种风险 |
| 评测带 | 用可回放样例、验证器、ledger、train/holdout 和 rollback 维护系统 | 一次修复伤害了别的案件,却没人发现 |
这五条带子共同定义了 Lawless 的产品边界。Web 工作区可以准备案件、选择技能、附加证据、启动智能体任务、渲染保存的交付物;但法律价值判断应留在智能体加技能的运行时,以及最终的人类审查里。桌面助手可以读授权邮箱、准备引用草稿、写入审批队列和安排后续;但发送、提交、删除、归档等外部动作必须经过更窄的权限规则。
这个边界看起来保守,实际是产品价值的一部分。专业工作不是越自动越好,而是越能说明“为什么现在该自动、为什么这里该停下”越可靠。
为什么旧形态会失败
脆弱的法律 AI 从一个用户问题开始,以一段润色过的回答结束。它感觉很快,因为它跳过了大量看似无聊的工作:通知是否真的上传到这个案件里,权利要求表是否使用了当前专利状态,引用来源是否支持结论,邮件草稿是否写给正确收件人,用户是否已经聘请了别的律所,草稿是否会形成不利立场。答案可以很像样,工作流却不可用。
专业工作有自己的失败面。缺文件比措辞弱更严重;引用错权威来源比语气不顺更严重;证据不完整时发出的草稿可能把客户锁进一个坏立场;专利应在 HIGH_RISK 却被放进 RELATED,会让审查者错过真正控制下一步的项目。
旧形态还缺少连续性。用户明天带着新的 PDF、对方律师的新邮件或审查者修改意见回来,聊天记录并不是一个好案件文件。系统必须从零散文本里重建问题。可恢复工作区则把文件、问卷答案、消息、活动、生成交付物、引用和报告画布放在一起,让下一轮从案件状态开始,而不是从模型记忆开始。
Lawless 的 Web 工作区因此采用左侧智能体流、右侧交付物画布的结构。左侧适合看进度、短结论和动作;右侧适合放长报告、证据矩阵、claim chart、TRO 路径卡、来源摘录和可复核草稿。这个布局不是装饰,它表达了一个工程判断:专业输出需要可以读、可以保存、可以重新打开的表面。
机制一:把接收当成案件状态,而不是 prompt 拼接
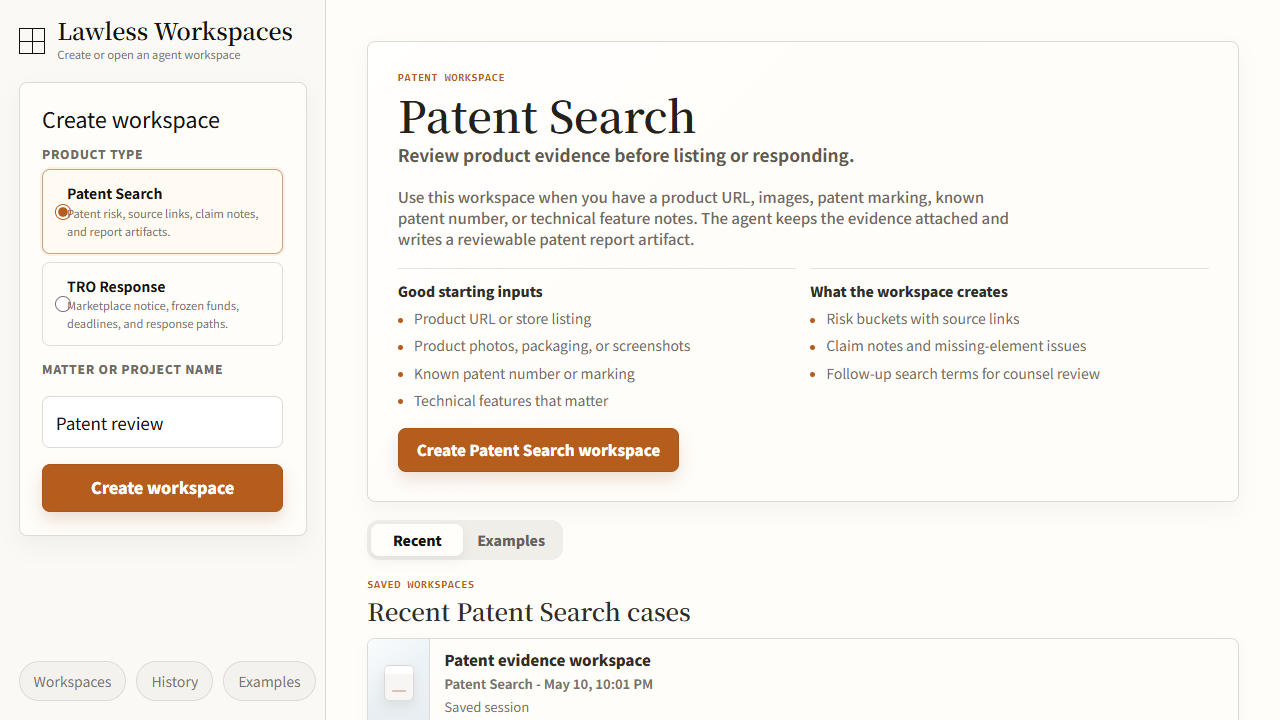
接收层决定智能体到底在做哪类工作。专利检索和 TRO 响应可以共用同一个 case workspace shell,但它们的案件定义不同。
专利接收会先问用户需要什么决策:亚马逊上架风险、产品发布 clearance、竞品专利审查、海关扣押审查、结算立场,还是系统自行判断的检索请求。随后系统收集产品 URL、图片、已知专利号、卖家或品牌信息、技术特征和不确定性,并询问研究深度:快速风险筛查、claim chart、中文摘要、来源链接审核或后续搜索词。
TRO 接收问的是另一组问题,因为冻结响应是案件状态问题。系统需要保存案件来源、平台通知、律所邮件、投诉或 TRO order、冻结金额、被诉产品销量、毛利、店铺区域、首选路径,以及卖家是要快速和解、证据优先回应、律师抗辩、平台解冻还是继续审查。
这些输入不是一次性塞进 prompt 的材料,而是工作区上下文。上传的通知、PDF、图像、法院文件、平台截图和问卷答案都成为案件输入。用户可以恢复工作区,交付物可以重新打开,智能体可以在同一案件状态上继续跑。这与“一个带附件的问题”是不同的可靠性模型。
桌面助手里的接收通常从邮箱开始。Outlook/M365 或 Gmail 同时是沟通渠道和证据存储:客户事实、历史消息、附件、截止时间和收件人都在里面。助手默认使用配置好的邮件提供商,避免跨提供商重复草稿,并把“起草”视为有边界的动作。对企业税务工作来说,这一点比炫技更重要:系统准备工作包,专家控制最终沟通。
机制二:证据先成为对象,再成为叙述
Lawless 中的证据不是报告末尾的链接列表,而是系统在报告到达审查者之前就可以解析、评分、渲染和质疑的一组对象。
专利检索最清楚地展示了这一点。answer-blind runner 接收输入案件、当前 skill、候选工具、种子查询和 query pack。它先写原始输出和来源 trace。trace 要覆盖产品识别、产品拆解、检索入口、检索运行、使用来源、claim/status 比较、证据决策和停止原因。原始输出必须以可解析的 HIGH_RISK 和 RELATED bucket 开始,然后才进入叙述报告。
工具层故意保持小而硬。Google Patents parser 解析标题、assignee、inventor、publication/grant counterpart、family evidence、claim window、legal-status window 和 NPL/product-title hint;claim risk matrix 在产品特征和专利字段都可用时生成复核提示;query pack 搜索准确产品标识符、技术特征、assignee、inventor、型号和来源标记术语。重点不是让工具替代律师,而是把产品桥、claim/status 桥和弱相关桥分开。
TRO 场景里的证据不是召回率,而是案件充分性。一个好的 TRO 工作包需要案件简介、资金暴露、缺失证据清单、响应路径卡和邮件草稿。证据清单本身就是产品功能,因为卖家通常不知道哪些事实重要。只有冻结金额、没有被诉商品销量是不完整的;只有投诉、没有平台截图是不完整的;只有结算目标、没有利润暴露是不完整的。智能体通过说清“还缺什么”来赢得信任,而不是通过抢先写一个自信立场。
税务邮件里的证据又是第三种形态:专家需要引用草稿、权威摘要、合适的中英表达,以及未解决假设清单。草稿进入审批队列之前,source preflight 要捕捉未解决引用、来源不匹配、缺少收件人、机械性问题和 reviewer finding。
在这些场景里,证据都是受控的中间表示。它让系统在中间阶段明确失败,而不是在最后阶段流畅失败。
机制三:草稿是后出现的交付物
Lawless 不把草稿当成第一反应,而把它当成证据组织完成后的产物。
专利报告应先有检索路径和候选分桶,再有叙述。HIGH_RISK 只放直接产品专利、同产品 publication/grant counterpart、同产品 design/utility sibling,或有强产品桥、claim/status 和辖区证据的近风险候选。RELATED 保留更弱但有用的记录:family context、低置信 source label、同 assignee 记录、竞品类比、历史专利、过期记录、abandoned application、foreign-only record 或 adjacent-risk patent。
这个区分让报告可审查。审查者看到 HIGH_RISK 时,知道这些记录应优先复核;看到 RELATED 时,知道这些记录解释周边环境,但暂时不应造成同等警报。系统不是删掉弱证据来显得精准,也不是把所有东西都推成高风险,而是把风险层级明确写出来。
TRO 响应的草稿同样不应早产。系统应该先形成路径卡:快速和解需要哪些事实,证据优先回应需要哪些附件,律师抗辩需要哪些管辖/期限/权利人信息,平台解冻需要哪些平台材料。邮件草稿只能引用已经进入案件状态的事实,并且应显式标出缺失材料。
桌面税务助手里,草稿的单位也不是一段回答,而是可进入审批的工作包:引用草稿、清单、批准队列项,有时还有预定 follow-up。助手可以读取授权上下文、创建草稿、写入审批队列;发送、提交、删除、归档和移动外部材料则与起草研究分开。scheduled run 只允许在无人值守时继续准备工作,不允许绕过审核发出外部通信。
机制四:ActionGate 把职业风险编码进产品
审批带是法律 AI 不再假装所有动作风险相同的地方。读邮件、起草回复、添加来源引用、向对方发送法律立场,是不同类别的行为。通用助手常把它们折成“调用工具或询问用户”;法律/税务工具必须把风险梯度写进运行时。
Lawless 桌面助手使用 ActionGate、审批队列和草稿目录作为人工检查点。计划运行可以继续做研究和草稿准备,但不能发送、发布、删除、归档或移动外部材料。路径受限写入、外部化动作拒绝列表和提供商一致性规则,把“能做什么”和“必须等待批准什么”分开。
这个机制会带来摩擦。用户要接受一个受监督的工作流,而不是一个表面上完全自动的助手。但对法律和税务工作来说,这个摩擦是正确交易。产品竞争力不在于原始自治感,而在于信任、审查速度和连续性:专家知道系统在哪些地方能帮忙,也知道它在哪里会停住。
机制五:评测维护的是工作框架,而不是一次提示
法律工作很少有一个单一标量奖励。专利检索、TRO 审查、证据提取、结算策略和税务来源起草,都需要交付物、trace 和可复核推理。Lawless 的 heuristic SDK 把分数视为验证器的一种,而不是最终真理。
评测工作框架包含 deterministic checks、智能体审查、人工审查占位、pairwise comparison、ledger、summary、train/holdout split 和 rollback。候选改进只有在改善被测行为时才保留;如果造成回归,就恢复之前的可变表面。被维护的对象可以是 skill 文件、工具脚本、rubric、runner strategy、示例、注释、交付物契约或验证器配置。
这与 Learning Beyond Gradients 的启发式学习观点相接近:系统不是通过更新模型权重来学习,而是通过维护模型周围的软件结构来学习。区别在于,法律场景没有 Atari 分数或物理仿真器,反馈更混杂:来源覆盖、召回、辖区边界、claim comparison、reviewer preference、证据纪律、成本和延迟。工作框架要把这些信号工程化,同时把最终法律判断留在指标之外。
当前证据
本地证据支持四个主张。
第一,Lawless 围绕案件状态而不是单次回复构建。Web case workspace 把专利检索和 TRO 响应分成不同 caseType,自动加载不同 skill,写入不同交付物路径,并使用与案件类型匹配的问卷。长法律交付物在右侧画布中呈现,智能体流保持简洁。
第二,产品边界把法律工作保留在智能体和 skill 运行时里。Web 应用禁止产品层硬编码法律/专利报告回退、硬编码候选专利、硬编码案件事实或直接写出案件工作流的专业结论。服务层可以准备和渲染工作区,原始交付物仍然是审查来源。
第三,桌面助手明确编码审批风险。引擎规则规定审批队列和草稿文件夹是人工检查点,不能调用发送、提交、删除等外部化动作。scheduled run 使用窄拒绝列表和路径限制写入来执行权限边界。
第四,专利工作流已经有可衡量的评测循环。本地 10-case answer-blind benchmark 中,无 skill baseline 的 high-risk recall 分别是 45.5% 和 27.3%;评测循环到 iteration 4 达到 90.9% high-risk recall 和 85.7% target recall,overall score 为 86.3%。iteration 5 回落后被 discard。这个结果不能被夸大成公开市场通用准确率,但它证明了一个内部检索策略可以在 blind 条件下被测试、修正和回滚。
税务邮件工作还有一个时间压缩证据:内部工作流测试把 30-40 分钟的研究/起草流程压缩为约 2-3 分钟的专家审查循环。更准确的读法是:系统把专家从空白页面移动到包含上下文、来源、草稿语言和开放问题的审查界面。专家仍然判断结论、语气、充分性和下一步。
边界
这些证据有真实边界。
专利召回结果来自内部 benchmark。它说明搜索和证据恢复工具可以改善该数据集上的候选恢复和分桶,但不能证明公开市场上的最终法律准确性、侵权判断、claim construction、有效性、可执行性或辖区完整性。面向用户的正确主张是候选恢复和 reviewer support,而不是法律意见自动化。
TRO 响应工作流比专利检索的评测更不成熟。当前已有工作区、路由、问卷、skill 绑定、交付物路径、案件状态模型和产品方向;下一步更有价值的评测应覆盖缺失证据识别、路径卡一致性、邮件草稿是否引用真实案件事实,以及用户是否可以在没有隐藏操作员干预的情况下从接收走到审查。
桌面助手的时间压缩来自工作流测试,不等于完全替代法律工作。它依赖输入质量、来源可用性、提供商连接、审查者期待,以及问题是否足够常规,能够安全准备草稿。
最后,工作带工程明确了专业判断的归属。法律结论、settlement posture、税务解释、客户沟通和最终批准仍由 reviewer 负责。系统赢得位置的方式,是让周围工作变得可检查,而不是让边界消失。
结尾
法律/税务 AI 最有价值的问题,不是模型能不能写出像专家的段落,而是系统能不能保存从混乱客户材料到可审查专业交付物的路线。
这条路线有一个形状:接收、证据、草稿、审批、评测。只要这些部分存在,智能体就能在有用的位置更自主:读授权材料、检索、解析、比较、起草、生成交付物、运行预定 follow-up,并用评测追踪自己的搜索策略。它也能在必须由人类专业人员决定的地方干净停住。
Lawless 的核心产品不是无限自治的智能体,而是一条能让边界可见的安全工作带。
参考材料
- lawless-desktop-agent-foundry: EngineAdapter、artifact-store、scheduler、ActionGate 相关实现。
- lawless-web-app: CaseWorkspace、/api/chat streaming、citationExtraction、workspace artifact tabs。
- patent-lawless: patent search contract、claim matrix、answer-blind eval loop。
- lawless-heuristic-sdk: snapshot/restore、ledger、verifier、train/holdout loop。
- Jiayi Weng, Learning Beyond Gradients, 2026.