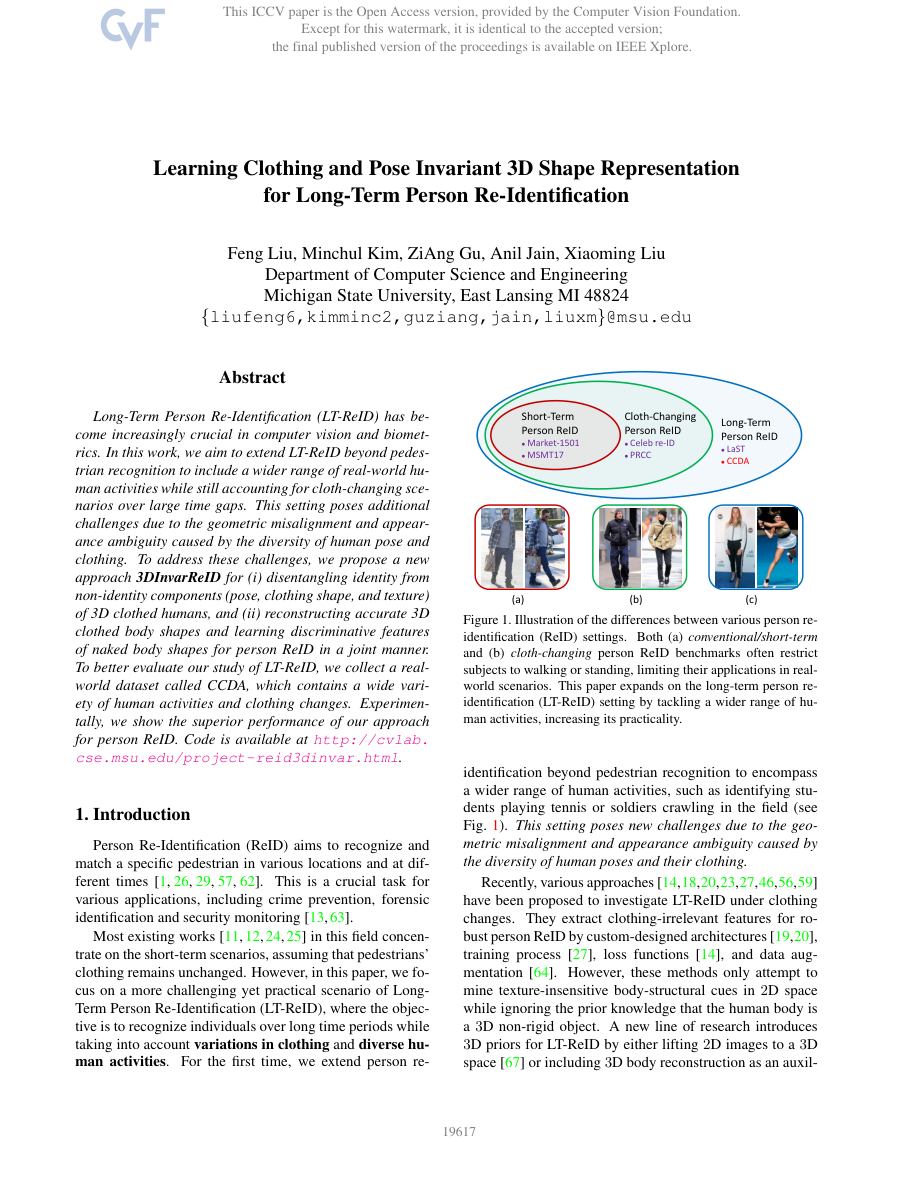
短期 ReID 指标可能奖励衣服纹理和背景捷径,不能证明模型抓住了长期身份线索。
数据设计围绕跨服装、跨活动、姿态和视角变化,让 3D shape representation 面对更难的身份评估。
贡献边界是数据设计和整理支持;20,000+ raw curation 不等同于公开 CCDA 最终规模。
Core Claim
把两张图片放进 person re-identification 系统里。第一张是篮球运动员站着拍摄的新闻照,第二张是同一个人在比赛中起跳、身体压缩、球衣变形、鞋子不同、光照不同,背景里还有其他球员。一个模型如果学到的是“红色球衣加球场”,它可能非常自信,但自信的理由是错的。真正的 long-term ReID 要求模型在衣服、姿态和背景都不再帮忙的时候,仍然保留对身份的判断。
这就是长期行人重识别的核心问题。短期 ReID 常常可以假设同一个人在较短时间窗口内再次出现,衣服相同,摄像头视角相近,动作也不会变化太大。Clothing-changing ReID 已经让问题变难,但很多 benchmark 仍然把人的活动范围限制在走路、站立或接近行人的动作里。我参与支持的 ICCV 2023 工作 “Learning Clothing and Pose Invariant 3D Shape Representation for Long-Term Person Re-Identification” 把场景继续向前推:当身份必须跨越换装、姿态、活动类型和强视觉歧义时,模型到底学到了什么?
我从这段工作里带走的判断很稳定:数据设计决定模型被允许利用哪些捷径。如果数据集让衣服、背景或姿态可以充当身份标签,模型就可能在分数上表现不错,却学错了任务。如果数据集强迫这些因素变化,模型才必须寻找更稳定的表示。
!ICCV 2023 ReID paper title page
捷径应该是第一个被怀疑的 baseline
Person ReID 通常被定义为检索问题:给定一个人的 query image,从 gallery 里找出同一身份的图片。CMC 和 mean average precision 这类指标奖励正确排序。在干净 benchmark 里,指标看起来客观;但在充满捷径的 benchmark 里,指标可能掩盖模型实际学到的东西。
Long-term ReID 最危险的捷径是外观。衣服纹理最明显,背景也很常见:同一个主体可能反复出现在同一个场景里,或者公众人物总是出现在某类场馆。姿态也会成为捷径。如果某个人的“挑战图”都来自一种活动,另一个人的挑战图来自另一种活动,模型可能学的是活动标签,而不是身份。
所以数据集本身就是方法的一部分。一个长期 ReID 数据集必须让容易的证据变得不可靠。同一身份应该跨衣服、跨活动出现;不同身份也应该可能有相似衣服、颜色和环境。query 和 gallery 的构造要避免 gallery image 变成 query 的近重复。否则,模型可以靠做一个很强的 clothing matcher 赢下 leaderboard。
ICCV 论文里的 3DInvarReID 从模型侧回应这个问题:学习 clothing- and pose-invariant 的 3D shape representation。数据侧的目标是同一件事的另一种表达:让衣服和姿态不能再充当可靠身份标签,让实验真正测量长期身份,而不是重复外观。
CCDA 设计要测的不是“更多图片”
论文引入了 CCDA,也就是 Cloth-Changing and Diverse Activities dataset,用来评测更接近真实活动范围的 long-term ReID。公开论文报告的数据集规模是 100 个 subjects、1,555 张图片。每个 subject 有两组图像:normal set,例如站立或行走;challenging set,例如运动或表演动作。gallery 每个 subject 随机取一张 normal image,其余 1,455 张作为 query set。
这个 split 用一段话就能说明,但设计选择很重要。normal gallery image 给模型一个身份锚点,challenging query set 则测试这个锚点能否穿过活动和衣着变化。以篮球运动员为例,challenging set 可能包含球场动作照,身体弯曲、局部遮挡、球衣、球、场地和其他球员都纠缠在一起。对艺人或 fashion model 来说,变化可能来自服装、舞台、姿态和图像风格。
我的角色是数据设计和整理支持,不是模型负责人。2023 年 summer RA 期间,我参与组织和筛选了更大的 20,000+ 跨服装、跨活动人体图像候选池。这个数字描述的是候选整理工作,不是最终发布的 CCDA 大小。公开论文里的 CCDA 是经过身份验证、裁剪、尺寸处理和 split 构造之后保留下来的 100 subjects / 1,555 images。
这个边界必须写清楚。研究贡献不能被夸大成“我主导了整个 ICCV 方法”,原始整理规模也不能和最终评测集混在一起。数据工作的价值在于塑造模型被测试的条件:哪些图像算作身份保持下的有效变化,哪些样本可能带来 label noise,哪些 query/gallery 选择会让捷径学习太容易。
难点在于什么变化该被保留
数据集工作很容易被写成体量工作:收集更多图像,清洗,发布。Long-term ReID 让我意识到这个说法不完整。真正难的是判断数据集应该包含哪种变化。
对这个任务有用的图片,不只是清晰的人体裁剪。它既要保留身份标签,又要改变 naive 模型最喜欢利用的信号。同一套衣服、同一场活动背景里的全身图很清楚,但对模型压力不大。模糊的动作照可能视觉上很难,但如果身份验证不确定,它带来的不是挑战,而是噪声。时尚图能引入强换装,但 pose、staging 和修图风格又可能形成新的相关性。
因此,数据整理面对的是一组实际判断:
• 这张图是否足够确定地保留了身份?
• 它是否引入了任务需要的衣服、姿态、活动或视角变化?
• 它是否会通过背景、球衣号码、logo、活动上下文或近重复来源泄露身份?
• 它更适合放在 normal gallery、challenging query,还是应该被排除?
• 最终 split 测的是变化下的身份,还是奖励系统再次找到同一套衣服?
这些问题听起来不华丽,但它们决定实验的科学含义。只有 benchmark 迫使 clothing invariance 成为必要条件,模型才有机会证明自己真的学到了 clothing invariance。
3D shape 是更难伪造的身份线索
论文的模型侧主张是:长期身份应该更多依赖稳定的 3D body representation,而不是只看表面外观。3DInvarReID 使用 joint two-layer implicit model,把 identity 和非 identity 组件拆开,包括 pose、clothing shape 和 texture。它一边重建 clothed 3D body shape,一边学习用于 ReID 的 discriminative naked body shape features。
论文的措辞很谨慎:如果能从 2D body image 中准确且有区分度地估计 3D naked body shape,那么它可以作为更可靠的身份线索。这个“如果”承载了大部分困难。模型必须从衣服、姿态、视角、纹理都互相混淆的图片里推断稳定身体表示。没有让这些因素充分变化的数据集,模型看起来像是在学身份,其实仍然可能依赖外观。
这就是数据和模型相遇的地方。模型说:我要把身份从衣服、姿态和纹理中分离出来。数据集说:这里有一组样本,衣服、姿态和纹理都不能被信任为身份。只有两边指向同一个目标,评测才有意义。
如何读 CCDA 结果
论文在 CCDA 上对比了两个 cloth-changing ReID baseline:ReIDCaps 和 CAL。公开 CCDA 结果里,ReIDCaps 的 mAP 是 10.9,Rank-1 是 6.5,Rank-5 是 20.2;CAL 的 mAP 是 19.3,Rank-1 是 10.0,Rank-5 是 26.7;3DInvarReID 的 mAP 是 21.7,Rank-1 是 11.1,Rank-5 是 30.5。
这些数字并不耀眼,而这正是数据集有意思的地方。低 Rank-1 告诉读者:CCDA 确实很难。结果的价值在于暴露长期 ReID 的难度,而不是把问题包装成已经解决。
消融表提供了更诊断性的视角。在 CCDA 的 ablation setting 中,完整 3DInvarReID 报告 mAP 17.5、Rank-1 36.3、Rank-5 56.4。去掉 3D module 后 Rank-1 降到 28.4;去掉 pre-training 后 Rank-1 是 29.3;去掉 3D clothing modeling 后 Rank-1 是 32.1。论文还在 HBW 上评测 3D body reconstruction,提出方法的 CD-L2 distance 是 0.610,低于 LVD 的 0.654 和 SHAPY 的 0.632。
这些表格的设置并不完全相同,所以不应该把所有数字压成一个单一分数叙事。更稳妥的读法是方向性的:CCDA 让任务足够困难;3D shape features 有帮助;clothing modeling 和 pre-training 都重要;reconstruction quality 需要和 retrieval accuracy 分开看。
我的贡献边界
我是 ICCV 论文的 co-author,贡献集中在数据侧:long-term ReID 的数据设计和整理支持。模型架构、训练策略和最终论文方法由研究团队主导。我的公开表述应该是:支持数据基础和实验设置,而不是主导完整 3DInvarReID 方法。
这个边界不会让贡献变小。对一个捷径敏感的问题来说,curation decision 会决定模型是否被测在正确任务上。工作涉及身份标签、活动变化、服装变化、候选过滤、query/gallery 边界,以及哪些样本会让实验变得太容易。最终论文把这部分压缩成数据集章节,但研究价值依赖这些决定足够准确。
最合适的一句话是:我帮助把 benchmark 做得更难被伪装。目标是降低模型靠衣服、背景或活动上下文冒充身份理解的可能性。
这段经历如何影响后来的评测思维
我没有把 ReID 模型带进后来的法律 AI 工作里,但我带走了评测直觉。
在 ReID 里,模型可能学衣服而不是身份。在 patent search 里,智能体可能学品牌关键词而不是风险检索。在 TRO response 里,助手可能学流畅法律模板而不是 case-specific evidence handling。每一种系统都可能在评测表面看起来很强,只要评测允许捷径存在。
所以我后来把评测看成一个设计对象,而不是 scoreboard。重要问题在 metric 之前:
• 什么捷径能让系统看起来完成任务,却没有真正解决问题?
• 哪个 split、heldout case 或交付物边界能暴露这个捷径?
• grader 看答案之前,应该先看到哪些证据?
• 哪些失败模式应该变成可复用测试,而不是一次性 anecdote?
• 即使指标提升了,它仍然不能证明什么?
这条线后来直接进入我的智能体评测工作:answer-blind runners、heldout cases、source policies、trace artifacts、verifier rubrics、rollbackable changes 和 failure taxonomies。领域从计算机视觉变成法律 AI,但核心怀疑没有变。如果评测允许捷径,系统就会找到捷径。
限制和风险
Long-term ReID 是敏感领域。论文也指出 person ReID 方法可能被用于不道德监控和侵犯隐私。讨论这项工作时,这个应用边界必须可见。它的技术价值在 representation learning、dataset design 和 confounding factor 下的评测;但同样的能力也可能进入有害监控系统。
证据边界也很重要。现有材料支持我在数据设计和整理中的角色、20,000+ 原始候选规模、ICCV 2023 论文背景、公开 CCDA 细节和报告指标。它们不支持我声称拥有完整 3DInvarReID 方法、模型实现或最终实验领导权,也不支持说 long-term ReID 已经解决。CCDA 分数显示的是困难设置里的改进,以及仍然很大的剩余空间。
这篇作品集文案因此应该保持两层诚实:一方面说明数据设计如何让捷径失效,另一方面承认贡献范围、应用风险和任务尚未解决。对我来说,这比把论文写成一个漂亮但过度扩张的成果故事更有价值。
参考材料
- Feng Liu, Minchul Kim, ZiAng Gu, Anil Jain, Xiaoming Liu. Learning Clothing and Pose Invariant 3D Shape Representation for Long-Term Person Re-Identification. ICCV 2023.
- CVF Open Access: https://openaccess.thecvf.com/content/ICCV2023/html/Liu_Learning_Clothing_and_Pose_Invariant_3D_Shape_Representation_for_Long-Term_ICCV_2023_paper.html
- arXiv: https://arxiv.org/abs/2308.10658
- Published CCDA details are cited separately from the broader 20,000+ raw RA-stage curation work.