04 / 专利
专利检索是一套召回与噪声控制工作框架
产品专利工作需要 query packs、来源解析、权利要求/状态比较、分组纪律和 answer-blind 评测,而不是一串链接。
产品专利检索同时面对两种风险:漏掉真正高风险专利,或者把弱相关材料堆成看似完整的报告。
系统维护 query packs、Google Patents parser、HIGH_RISK / RELATED 分组、claim/status/evidence matrix 和 grader。
内部 benchmark 支持 candidate recovery 改善;最终侵权判断、地域覆盖和法律意见不在自动化结论内。
Core Claim
一次早期专利检索失败得很像成功。
输入是一条 Amazon 商品页:LiveFull 恒温压缩毛巾分配器。本地 benchmark 里的预期专利标签是 US7784424B2。一次冷启动隔离运行检查了页面,没有找到可见专利标记,于是搜索 Google Patents,最后返回 NONE。这个答案干净、简短、看起来很克制,但它错了。
后来,检索策略扩展以后,同一个案例又以相反方式失败。系统找回了 US7784424B2,却把它放进 RELATED,没有输出任何 HIGH_RISK 专利,同时带出了 25 个相关候选:CN、JP、KR、EP、WO 和 US 记录,围绕毛巾分配器、湿巾、加热布料和相近机构展开。benchmark 因为目标出现在输出里,给这一行的 required target recall 算作完整;但 high-risk recall 仍然是 0。系统学会了找到针,却拒绝把针放进正确的托盘。
这就是产品专利检索的真实形状。难点不是生成一页专利链接,而是同时维持三件事:
不能漏掉与产品强相关或 claim 风险高的专利;
不能让这些专利被弱类比和同族噪声淹没;
每一个 HIGH_RISK 标签都要有产品身份、claim 或外观重合、法律状态和来源证据支撑。
一旦这些约束可见,专利检索就不再像浏览网页,而更像一个工作框架。这个框架由 query pack、deterministic parser、evidence matrix、bucket contract、answer-blind 评测和 rollback 组成。它的目标是提高召回,同时不奖励噪声。
链接列表隐藏了什么失败
普通搜索界面很难诊断 LiveFull 这种失败。如果系统返回 NONE,用户不知道产品是否真的没有专利线索,Amazon 是否把标记藏在图片里,正确专利用了更早的技术词汇,还是查询太早收缩。如果系统返回 26 个专利号,用户面对的是相反问题:目标可能在里面,但有用信号被大量技术邻居稀释。
本地 benchmark 把这种模糊变成可测对象。在 10-case patent-number benchmark 中,每一行都有产品输入和一个带答案的目标文件,runner 不允许读取答案文件。当前样例包括 marketplace 商品页、官方产品页和一个 image-only 产品身份案例。预期输出也不是扁平列表,而是有类型的结果。
| Case | 产品类型 | 预期高风险信号 | 主要陷阱 |
|---|---|---|---|
| PN-001 | LiveFull 压缩毛巾分配器 | US7784424B2 | 当前页面证据很难复现历史来源标签 |
| PN-002 | Upright 姿态设备 | USD958784S1 | 来源行有可疑额外标签,不应自动升为 HIGH_RISK |
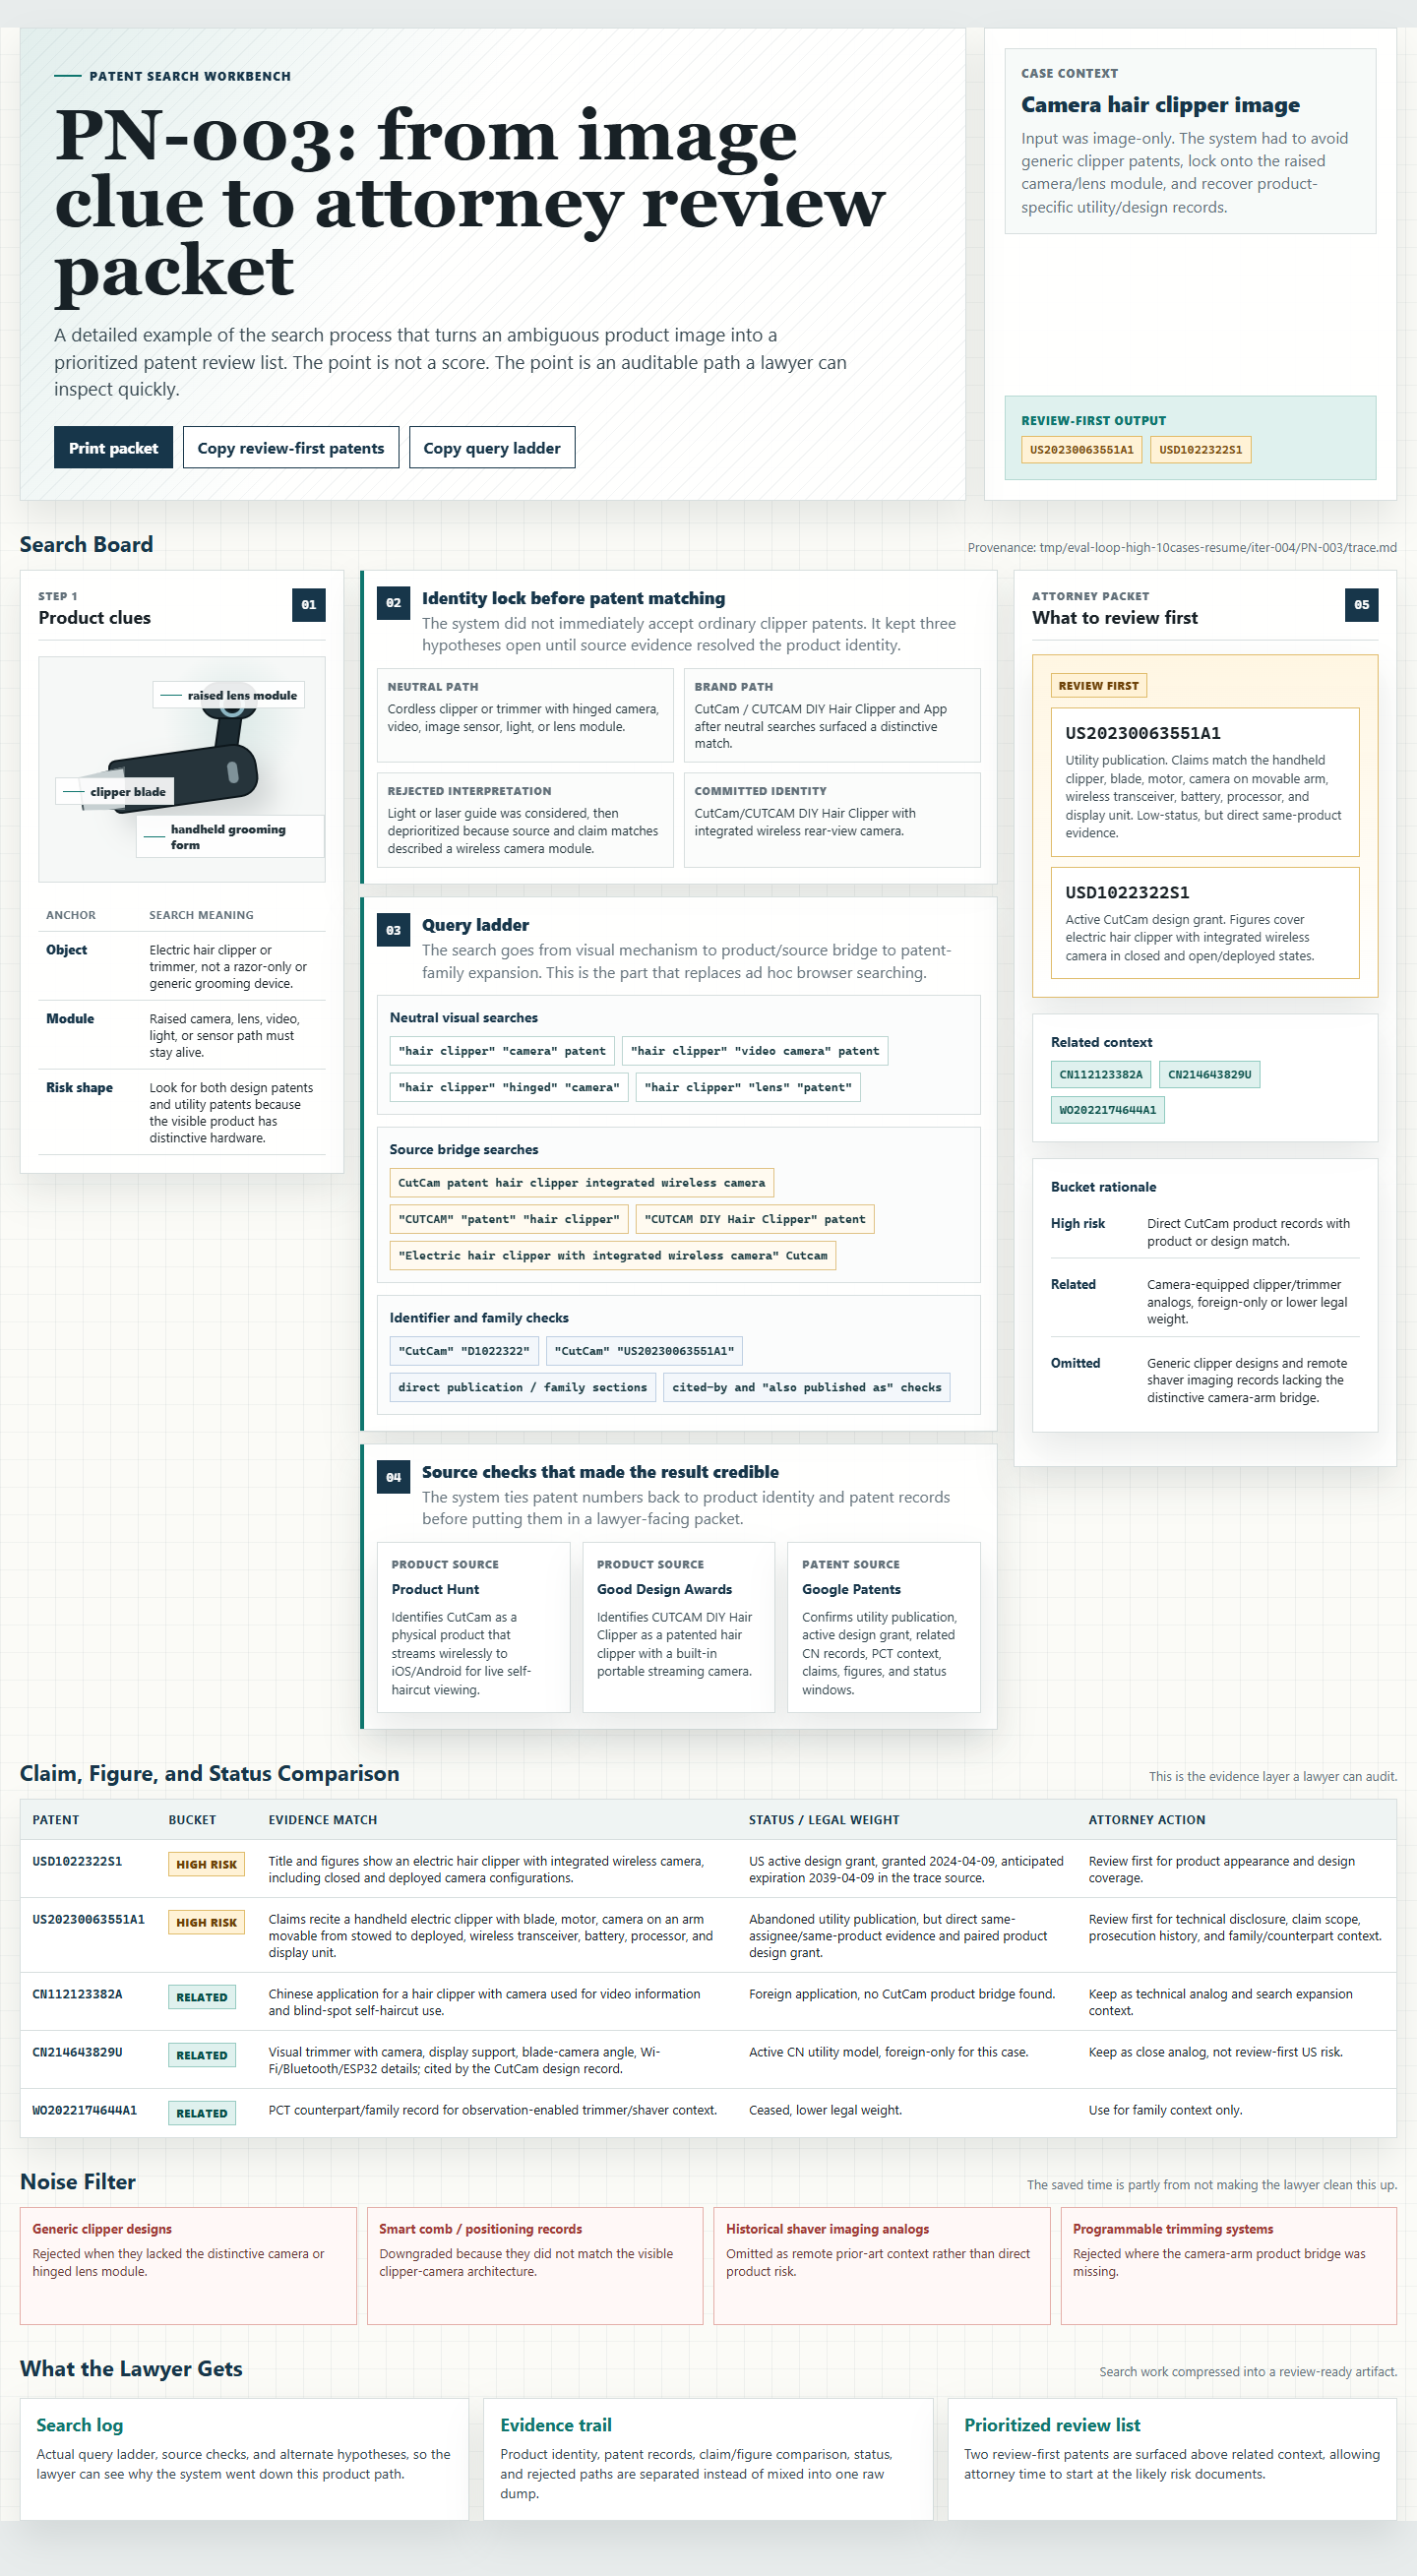
| PN-003 | 带摄像头理发器产品图 | US20230063551A1, USD1022322S1 | solver 不能复用 Upright URL 假设 |
| PN-004 | Fat Brain Toys Air Toobz | US12551812B2, US20220126217A1 为 RELATED | grant/application counterpart 很关键 |
| PN-005 | Grillbot 烤架清洁机器人 | US9161612B2 加 family signal | family expansion 容易变成失控噪声 |
| PN-008 | Momcozy 便携母乳冷藏器 | USD1094021S1, utility application 为 RELATED | design 证据强于 utility 证据 |
这个 benchmark 围绕的是产品风险问题:“律师或产品运营应该先复核什么?”这不同于“我能从网页上刮到哪些字符串”。历史 source label 仍然重要,但命中 source label 不自动等于高风险法律结论。PN-002 是清楚例子:来源表保留了 US20230063551A1、USD958784S1 和 CN213381662U;typed schema 把 USD958784S1 视为直接 HIGH_RISK 目标,而另外两个只有在更强产品证据出现时才可能进入风险列表。扁平 exact-match 指标会惩罚系统拒绝夸大弱标签;纯风险指标又会忽视来源标签恢复。工作框架需要同时看这两面。
契约:把风险和相关证据分开
输出契约故意很小:
HIGH_RISK:
US1234567B2

RELATED:
US20230000000A1
HIGH_RISK 只保留直接产品专利、同商业产品的 publication/grant counterpart、与同一商品绑定的 design/utility sibling,或有强产品证据与 claim/status 证据的 active close FTO-risk candidate。
RELATED 吸收有用但较弱的证据:family context、产品桥不完整的 source label、同 assignee 记录、竞品类比、历史专利、过期记录、abandoned application、foreign-only record 或相邻风险专利。
这个契约做了两件有价值的事。
第一,它允许召回保持宽。一个弱但有支撑的 family member 可以留在 RELATED,而不是为了显得精准被删掉。在产品风险工作里,遗漏很贵:律师检查 continuation、priority chain、产品变体或辖区时,弱项可能突然变重要。
第二,它防止宽召回把自己洗成高风险。一个专利可以在技术上相关,却不该和产品页标记、精确外观匹配或映射到产品机构的 active claim 处在同一优先级。bucket contract 给评测器一个位置说:“保留它,但现在不要用它吓到运营人员。”
LiveFull 后期失败因此很有信息量。找回 US7784424B2 是进步;只把它放在 RELATED,说明检索层比分桶策略进步得更快。框架能看见这种差异,因为它把 high-risk recall 和 target recall 分开计量。
Query pack 是受控扩展,不是头脑风暴
系统使用 query pack,是因为产品专利检索很少只有一个稳定名称。marketplace 用零售语言,专利用更旧的技术词汇;产品页可能提到 ASIN、品牌名、法律所有人、型号、包装声明、说明书和没有号码的 patent pending;图片通过形状、按钮、腔体、镜头、屏幕、刀片、阀门或 cartridge 传递产品身份。
query pack 把这些信号转成有边界的检索路径。对于 URL 输入,runner 先读取可见页面文本和结构化 metadata,再围绕 patent、Pat.、protected by、patent pending、continuation、family 等标记找线索。如果直接标记失败,runner 提取品牌、卖家、legal owner、ASIN、型号、精确标题和两三个机构特征,并形成几类查询。
| 查询家族 | 示例锚点 |
|---|---|
| 精确来源 | 产品标题、ASIN、型号、说明书标题、官方产品页 |
| 专利标记 | patent no, U.S. Patent, protected by, patents pending, virtual patent marking |
| 实体 | 品牌、legal owner、trademark owner、assignee、inventor |
| 机构 | compressed towel, heated towel dispenser, water reservoir, sensor, dispensing apparatus |
| counterpart | publication/grant pair、design/utility sibling、family member |
| 图片身份 | 接受品牌相似物之前的中性视觉锚点 |
PN-001 的 builder notes 说明了为什么这有必要。失败反复锁定了产品身份,也找到了看似合理的机构候选,但查询主要停在现代零售措辞。后续实验加入了窄 fallback:wet towel dispensing apparatus、moistened towel dispenser、heated towel dispensing apparatus、dry compressed towels liquid dispenser。这不是允许接受所有毛巾专利,而是给薄 storefront 或 private-label 页面增加一条旧技术词汇路径。
图片案例也需要同样纪律。PN-003 起点是一张本地图片,不是产品 URL。图片看起来像带摄像头的理发器,但 image-only 运行很容易过拟合到外观相似商品。skill seed 要求 identity-challenge gate:记录中性视觉锚点,至少跑两个身份假设,并且只有当图片或周边来源确认品牌/型号,或者 claim 更好地匹配独特可见机构时,才把某个品牌专利提升为 HIGH_RISK。
这就是查询扩展和噪声的区别:可以扩展,但每一次扩展都要保留理由。
Parser 给智能体比 snippet 更硬的支撑
搜索 snippet 对专利风险分桶太薄,所以系统给 runner 一组 candidate-tools/ 下的 deterministic helpers。这些工具故意很小。
| Helper | 工作 |
|---|---|
| query_pack.py | 生成 exact-anchor、fallback、entity、family 和 image-query plan |
| google_patents_parser.py | 在已知候选号或页面时解析 Google Patents 记录 |
| claim_risk_matrix.py | 比较产品特征与 claim/status 证据,输出复核提示 |
parser 不是法官。它提取能让下一步判断可检查的字段和窗口:标题、assignee、inventor、publication/grant counterpart、family evidence、claim excerpt、legal-status window、NPL 或 product-title hint,以及 relation window。runner 因此可以问更具体的问题:
• 专利页是否命名同一产品、品牌、assignee、inventor 或商业标题?
• 这是 grant、publication、design patent、foreign counterpart、expired patent、abandoned application 还是 active record?
• abstract 或 claim window 是否包含产品机构,还是只有 broad category match?
• design patent 是否是强产品级匹配,而 utility application 只是 RELATED?
• 初始命中后是否出现 publication/grant counterpart 或 family member?
这些区分很重要,因为专利噪声在标题层面常常很像真信号。一个 “towel dispenser” 专利可能值得复核,却仍然无法建立 LiveFull 产品桥;一个 posture-device design patent 可以是 HIGH_RISK,而同一来源行里的 hair-clipper 标签仍然可疑;一个 breast-milk cooler design patent 可以是最强直接匹配,而配对 utility application 仍然低置信。parser 让这些差异显出来,而不是留在聊天 trace 里。
Claim/status/evidence matrix 是法律风险检查点
专利号本身不是风险评估。每个被接受的候选都应该有一行紧凑证据。
| 字段 | 为什么重要 |
|---|---|
| Product bridge | 产品页、说明书、包装、virtual marking 页面、精确商品标题、图片/外观匹配或官方来源 |
| Technical overlap | 产品特征与 abstract 或 claim window 的比较 |
| Legal status | active、pending、granted、expired、abandoned、withdrawn、rejected、ceased 或 foreign-only |
| Jurisdiction | 记录是否影响被审查市场 |
| Relation type | direct match、counterpart、family member、design/utility sibling、competitor analog、weak related |
| Bucket | HIGH_RISK 或 RELATED,以及弱记录没有提升的理由 |
一个有用迭代加入了窄 low-status exception。在 PN-003 中,runner 找回了同商业产品的 utility publication 和 active design patent,但因为 utility publication 状态较低而将其降级。实验把策略改成:US utility publication/application 只有在存在 exact same-commercial-product 证据、同时找回 active same-product design/grant/product-image sibling,并且 claim mechanism 匹配时,才可以留在 HIGH_RISK。竞品类比、foreign-only 记录、旧 generic parent 和没有 exact product bridge 的记录仍留在 RELATED。
这条规则很小,但捕捉了框架需要的判断方式。目标不是让法律状态不重要,而是在低状态记录属于同产品证据链时,不因状态过低而损失召回。
Answer-blind 评测保持检索诚实
工作框架把 runner 和答案文件分开。
评测时,search runner 只能读公开输入、当前 skill 和无答案 helper tools。它不能读 patent-number-answers.md、combined benchmark、grading schema 或 reasoning trace。runner 写出每个 case 的输出和 trace 后,scorer 再用私有 target 比较结果并写 score report。
builder 的角色不同。它可以看 score report、answer files、raw outputs、traces、candidate tools、上一轮交付物和 failure summaries。它的工作是提出一个对 skill 或工具的小改动,验证这个改动,再运行下一轮 answer-blind 评测。如果候选改进了选定指标,就保留;如果回归,就丢弃并恢复 previous best workspace。
这个循环更像工程工作框架,而不是一次 prompt tweak:
answer-blind 评测 runner
-> scorer
-> planner / builder
-> answer-blind 评测 runner
-> keep or rollback
已检入的评测 notes 命名了三项主要 round metric。
| Metric | 含义 |
|---|---|
| overall_score | 产品风险有用性和 required-target recovery 的灵活评分 |
| high_risk_recall | 预期高风险目标是否出现在 HIGH_RISK bucket |
| target_recall | 预期高风险和相关目标是否出现在任意输出位置 |
默认目标接近 90% score/recall。这个目标是 gate,不是营销口径。一次运行可以改善一个指标,但如果伤害组合结果,仍然会被丢弃。
本地证据显示了什么
最强的已检查本地证据是 10-case answer-blind benchmark 和它的迭代 ledger。
两个无 skill CLI baseline 都很弱:
| Run | Overall score | High-risk recall | Target recall |
|---|---|---|---|
| Codex no-skill baseline | 16.7% | 45.5% (5/11) | 42.9% (6/14) |
| Claude no-skill full baseline | 15.4% | 27.3% (3/11) | 21.4% (3/14) |
评测循环 ledger 随着保留迭代而提升:
| Iteration | Overall score | High-risk recall | Target recall | Decision |
|---|---|---|---|---|
| 1 | 71.4% | 63.6% | 50.0% | keep |
| 2 | 79.8% | 72.7% | 64.3% | keep |
| 3 | 83.3% | 81.8% | 85.7% | keep |
| 4 | 86.3% | 90.9% (10/11) | 85.7% (12/14) | keep |
| 5 | 81.1% | 81.8% | 71.4% | discard |
Iteration 4 是关键证据点。它跨过了 high-risk recall 目标,但 overall 和 target-recall gate 仍未全部达到,也留下了未解决案例。Iteration 5 说明 rollback 为什么重要:后续候选虽然在某处恢复了 PN-001,但整体框架回归,因此被丢弃。
同一批文件也暴露噪声问题。某个后续 strategy-loop 的 deterministic score report 在 10-case set 中出现 10 个 true positives、116 个 false positives 和 6 个 false negatives。专利级 micro precision 只有 7.9%,尽管 recall 达到 62.5%。在 target 层面,同一运行找到了 9/11 个 high-risk targets 和 10/14 个 required targets。这个组合说明单一 “accuracy” 数字会误导:系统可能很会浮出正确专利家族,但对用户可见 HIGH_RISK 列表仍然太吵。
Top-k recall 在这里意味着什么
“top-k recall” 在这个项目里必须小心使用。本地 benchmark 输出是 bucketed,不是有正式 k = 10 截断的 ranked search-results page。更稳妥的读法是 candidate-set recall:预期专利是否出现在输出的 HIGH_RISK 或 RELATED 候选集中,以及是否出现在正确优先级 bucket。
在这个读法下,证据是有用的:
• PN-004 在 counterpart search 改进后,从 iteration 1 的零 target recall 移到 iteration 2 的 full target recall。
• PN-003 在 image-identity 和 low-status direct-product policy 改进后,从早期零 high-risk recall 移到 full high-risk recall。
• PN-008 在 iteration 3 同时恢复 design patent 和 paired utility/application 后达到 full target recall,随后在 iteration 5 回归。
• PN-001 仍然顽固:target recovery 和 bucket placement 可以独立变化,说明 top-k 式候选召回还不够。
这不是公开网络专利检索准确性的证明。它不证明侵权、有效性、claim construction、可执行性、design-patent substantial similarity 或辖区 freedom to operate。它也不证明旧生成公开材料中“约 100 个内部样本”的更宽主张,除非对应样本 ledger 被检查。这里经过验证的本地交付物更窄:10 个产品案例、11 个 high-risk target、14 个 required target、answer-blind runs 和 per-case traces。
这个较窄主张仍然有价值。它证明检索策略可以在不把答案泄露给 runner 的条件下被评测和改进,也证明当召回收益带来太多噪声时,系统可以回滚。
为什么旧方法难以处理这个问题
普通关键词检索容易运行,但难以信任。它能浮出专利页面,却不知道结果来自产品标记、同 assignee family、竞品类比还是 generic title match。它把链接交给审查者,把风险结构留在隐含状态。
单次 prompt 很灵活,但不稳定。它可能像早期 LiveFull 运行那样,在一次看起来干净的检索后把 NONE 当成克制答案;也可能过度扩展 family,把每个 sibling 都呈现得像同等风险。没有 answer-blind regression,就没有持久记忆说明哪次改动帮了哪个失败。
严格 exact-match scorer 也很脆。它会惩罚系统把可疑 source label 当成弱证据,即使这才是正确的产品风险姿态。它也分不清漏掉 high-risk grant 和省略低置信历史标签。
纯法律风险 grader 也不完整。它可能奖励有用类比,却忽视已知产品专利被漏掉。对一个第一义务是 recall 的检索系统来说,这很危险。
工作框架的做法是拒绝把问题压成一个数字。它同时衡量 high-risk recall、required target recall、exact source-label behavior、precision/F1、process discipline、claim/status comparison 和 risk usefulness。runner 不只被评估“找到了什么”,也被评估“把证据放在哪里”和“能不能为这个位置辩护”。
产品教训
对卖家或产品团队来说,输出不应该像搜索结果页,而应该像复核队列。
| 复核项 | 用户需要知道什么 |
|---|---|
| HIGH_RISK patent | 为什么这条记录应该先看 |
| RELATED patent | 为什么它有用但较弱 |
| Claim/status evidence | 哪些产品特征重合,观察到什么法律状态 |
| Source bridge | 产品到专利的连接来自哪里 |
| Missing evidence | 哪些证据会提升或降低候选 |
| Next search terms | 具体后续检索词,而不是泛泛 metadata |
这也改变了智能体的角色。智能体不是替代专利律师给法律意见,而是把混乱产品页、图片或 brief 转成一组结构化候选权利和证据缺口。人类审查者应该把时间花在 claim scope、design similarity、jurisdiction、validity 和商业决策上,而不是重建某个随机专利链接为什么出现。
仍未解决的部分
最难的失败仍然发生在产品证据很薄、过时、藏在图片里,或由 private-label 卖家中介的时候。PN-001 是典型:benchmark 期待 US7784424B2,但当前检索证据很难复现直接产品页标记。太严格的 runner 返回 NONE;太宽松的 runner 用一组 towel-dispenser analog 填满 RELATED。有用方案不是放松一切,而是为 thin storefront 增加窄接受机制:旧机构词汇、claim/status 检查和更明确的分桶理由。
第二个未解问题是排名。bucketed recall 比扁平链接列表更好,但不是完整 ranked retrieval 评测。生产级 top-k 指标需要稳定候选排序、定义好的 k、family member 去重规则,以及 direct product marking、family/counterpart recovery、design similarity、utility claim risk 和 weak related context 的分项评分。
第三个问题是证据新鲜度。marketplace 页面会变化,专利标记会消失、移入产品图片或制造商页面;Google Patents 页面可能无法被本地 parser 访问;官方页面可能比 marketplace snippet 更可靠,但前提是 runner 找得到官方页。工作框架能暴露这些失败,但不能通过断言让陈旧证据变新。
第四个问题是法律边界。HIGH_RISK 的意思是“应优先复核”,不是“构成侵权”。matrix 是 triage 交付物,可以显示 claim window、产品重合、状态和辖区线索,但最终法律结论仍需要律师审查和案件特定分析。
结尾
这个项目的核心不是把商品链接变成专利链接,而是把产品专利检索做成一个可测试、可回滚的 recall-and-noise-control 工作框架。
真正的问题有两边。漏掉高风险专利会伤害卖家决策;把弱相关专利塞进 HIGH_RISK,也会制造误报和复核成本。Lawless 的做法是让系统在这两边之间留下可审查的中间对象:query pack、parser、evidence matrix、bucket contract、answer-blind 评测和 rollback。
它证明的不是“AI 可以自动给出专利法律意见”,而是更窄也更有用的一点:一个内部检索策略可以在 blind 条件下被评测、修正和回滚,并把专利号、来源、claim/status、产品特征和风险 bucket 组织成专家可以复核的材料。
参考材料
- patent-lawless/web/api/patent-search.js
- patent-lawless/web/lib/patent-contract.js
- patent-lawless/scripts/google_patents_parser.py
- patent-lawless/scripts/claim_risk_matrix.py
- patent-lawless/scripts/score-patent-eval.mjs
- Jiayi Weng, Learning Beyond Gradients, 2026.