06 / 评测
法律 AI 智能体失败时,把失败保存下来
法律 AI 要谈得上学习,先要有 answer-blind 运行、评分器、ledger、snapshot、train/holdout 切分和回滚。
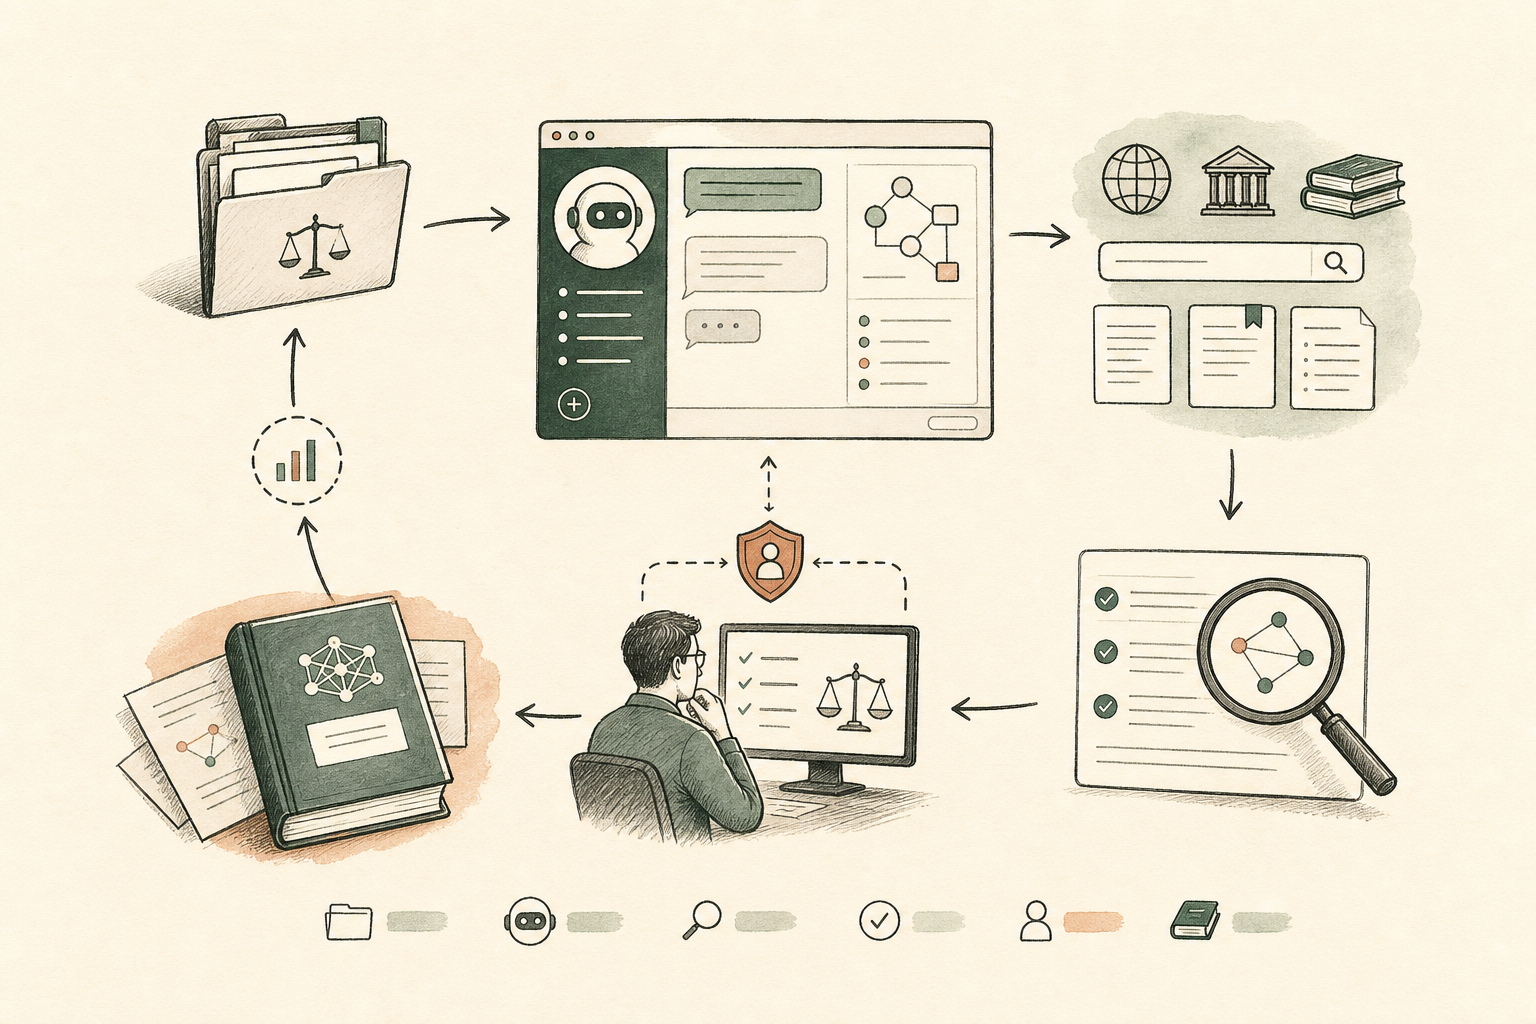
改一句 prompt 不能解释系统为什么变好,也不能保证没有在 holdout 或旧能力上退化。
runner、grader、trace artifacts、snapshot/restore、ledger、verifier rubric 和 train/holdout 共同决定是否保留改动。
学习对象是 skill、tool、rubric 和 artifact contract,不是不可解释地训练模型权重。
Core Claim
一个专利检索智能体可以看起来很能干,同时错过真正重要的部分。它读取产品页,打开专利来源,返回一组干净的专利号,并解释每个专利为什么相关。然后 grader 把结果和隐藏答案集一比,差距出现了:智能体找到了看起来合理的 RELATED 专利,却漏掉了 reviewer 最该先看的直接 HIGH_RISK 专利。
这种失败比一条看似成功的回答更有价值。它包含让系统困惑的输入、检查过哪些来源、输出了哪些专利、漏掉了哪些专利,以及为什么这个交付物还不够好。法律 AI 工作流真正的问题是:这个失败能不能变成持久更新,同时不把答案泄露给下一轮,也不悄悄破坏另一个案例。
这里的项目是一个面向法律 AI 的启发式评测循环。核心主张很简单:法律 AI 更安全的改进方式,是把失败案例变成可回放、可评分、可回滚的工作框架更新。被维护的对象不是模型权重,而是模型周围的系统:skills、tools、source policies、runner prompts、rubrics、交付物契约、examples、traces 和 ledgers。
这个想法和 Jiayi Weng 的 Learning Beyond Gradients 相邻。那篇文章讨论 coding 智能体如何通过 feedback、tests、logs 和 replays 维护启发式系统,同时不更新神经网络权重。法律版本的质地不同:这里没有 Atari 分数,没有物理模拟器,也没有一个奖励函数能概括专利检索或 TRO 响应是否有用。反馈更混杂:来源覆盖、召回、辖区边界、claim comparison、reviewer preference 和证据纪律。循环必须把这些当作工程信号,同时把最终法律判断留在指标之外。
失败的形状
最初的任务是电商风险复核里的 product-to-patent search。给定产品 URL、产品图或产品 brief,智能体要找回专利号,并把强产品风险匹配和更宽的相关上下文分开。输出契约使用两个主要 bucket:HIGH_RISK 放强产品或 claim 匹配,RELATED 放有支撑的 family、counterpart、历史或相邻风险专利。
这个 bucket 边界很重要。一个宽泛的专利 family dump 可以看起来很忙,却很难复核。一个漏掉的高风险 design patent 会让报告不可用,即使报告里有几十个相邻专利。一个 foreign-only 或 expired patent 仍然可能是有用背景,但不应被呈现为与 active direct product patent 同等风险。法律工作里的错误很少只是“答案错了”,更多时候是证据排序错、scope label 错、source bridge 缺失。
第一个可靠改进,是停止把每一次 miss 当成一次性的 prompt 问题。benchmark 把公开输入和隐藏答案分开。runner 可以读产品事实和当前 search skill,但不能读答案 key。它必须先产出交付物:output buckets、traces、source notes 和 structured evidence。只有在这些交付物写出来之后,grader 才读取隐藏答案并评分。
这个 answer-blind 边界改变了“修复”的含义。如果智能体漏掉 PN-004,maintainer 不能简单地把预期专利贴进 prompt。它必须改进可复用检索行为:如何识别 owner,何时检查 patent marking,何时 fallback 到 Google Patents,如何处理 family signal,以及如何判断某个专利属于 HIGH_RISK 还是 RELATED。
工作框架
这个工作框架有五个任务。
第一,answer-blind runner 用当前 skill 运行每个 case。在 SDK 版本里,runner 接收 task、example input、round number、run directory 和必需交付物路径。Codex-backed runner prompt 明确要求 worker 写出所有必需交付物,并且不能读取 heldout answers 或 score files。专利 benchmark 里也有对应的无答案输入文件,例如 patent-number-inputs.md、design-patent-inputs.md 和 utility-patent-inputs.md。
第二,grader 检查交付物。有些检查是确定性的:交付物是否存在,是否包含必需字符串,bucket parser 是否能恢复 normalized patent identifiers。另一些检查依赖智能体或 reviewer:trace 是否把产品特征和 claim/abstract window 比较,是否区分 active legal scope 与 foreign-only/expired context,是否解释 NONE 结果是纪律性判断还是失败检索。
第三,每次运行写 ledger。task loop 记录每个 case 的 split、交付物路径、verifier results、score 和 pass/fail state。system loop 记录 baseline、每个 candidate change、train score、holdout score、generalization gap、pairwise comparison result、change risk、keep/discard decision 和理由。ledger 是工作框架的记忆,它防止下一个 maintainer 把 benchmark 重新体验成一堆新鲜轶事。
第四,循环在每次 candidate update 之前 snapshot mutable surfaces。mutable surface 可以是 skill 文件、rubric、tool directory、notes 或交付物契约。maintainer 提出改动后,系统评测 candidate。如果改动改善选定指标,或赢得配置好的 pairwise comparison,就保留;如果回归,就恢复 pre-candidate snapshot。
第五,train/holdout split 保持循环诚实。一个 candidate 改善 training cases 却伤害 heldout cases,不是真改进。SDK 每轮报告 overall score、train score、holdout score 和 generalization gap。命令行工作框架可以在泛化优先时按 holdout performance 选 best candidate。
结果更接近测试工作框架,而不是 prompt library。一个法律 AI skill 可以进化,但每次更新都要经过同一套机械结构:blind run、交付物捕获、grading、ledger entry、snapshot decision,以及必要时 restoration。
专利运行显示了什么
最清楚的本地证据来自一个 10-case patent-number benchmark。循环从一个 warm skill 开始,跑了五轮。第一轮的 public score report 会 redact expected patent numbers,让 builder 智能体可以读失败而不看答案。它仍然暴露有用信号:per-case result、score、high-risk recall 和 target recall。
Iteration 1 的 overall score 是 0.7140,high-risk recall 是 0.6364,target recall 是 0.5000。几个 case 通过了,但失败很有信息量。PN-001 返回了很长的 RELATED 列表,却让 HIGH_RISK 为空;PN-003 输出了看似合理的专利,却漏掉预期直接目标;PN-005 找到了 high-risk items,但只覆盖一半 target set;PN-008 找到了一个 design patent,却仍然缺少部分目标故事。
到 iteration 4,最佳运行达到 0.8630 overall、0.9091 high-risk recall 和 0.8571 target recall。这是有意义的改进,尤其是 high-risk recall 跨过了 90% 目标。循环没有宣布胜利,因为 target recall 仍低于配置目标,几个 case 仍然不稳定或未解决。
Iteration 5 是关键。它的 overall score 掉到 0.8110,high-risk recall 掉到 0.8182,target recall 掉到 0.7143。循环丢弃了它。
这个 discard 是“我们从失败中学习”和“我们不断 patch,直到 prompt 难以推理”之间的差别。法律 AI 系统尤其容易局部过拟合。新规则可能帮了一个产品家族,却降级了另一个;更宽的 query expansion 可能提高召回,却把 reviewer 淹没在 noisy patent families 里;更严格的 source policy 可能减少幻觉引用,却漏掉有效间接证据。没有 rollback,这些取舍会变成隐藏债务。
运行后的 learning file 仍保留未解决 case。PN-001 在最新实际集里 target recall 完整,但 high-risk recall 仍是 0.0000,说明问题更像分桶或风险分类,而不是简单专利发现。PN-004 不稳定,high-risk 和 target recall 都是 0.0000。PN-005 high-risk recall 为 1.0000,target recall 为 0.5000,说明是 family 或 target completeness 问题。PN-002、PN-006、PN-007、PN-009 和 PN-010 等稳定 case 则成为 regression anchors。
这正是法律评测应该暴露的混合状态。一个单分数会隐藏 retrieval failure、bucketing failure、family expansion failure 和 legal-scope failure 的差别。工作框架把这些失败模式拆得足够开,让 maintainer 能行动。
为什么 answer-blind 重要
answer-blind 评测很容易描述,但当智能体开始编辑自己的指令时,它很难维持。
search 智能体应该看到公开 case input:产品 URL、图片、产品描述和当前 skill。它不应该看到 answer key、source-label mapping、透露目标的 grader policy 或之前隐藏分数。grader 可以在输出产生后读取这些文件。builder 可以读取 redacted public failure summaries 和 traces,再更新 skill 或 tools,但不应记住 case-specific answers。
这个边界把 benchmark 变成真实评测。如果 candidate skill 学会 PN-002 期待某个 design patent,下一轮可以看起来完美,却更不泛化。如果它学会 “Upright posture trainer” 需要 owner search 加 design-patent terms,那就可能迁移。区别不是哲学问题,而是文件布局问题:input files 对 runner 安全;answer files 和 grading schemas 不安全;public score reports redact expected patent numbers,使 planning 能在不泄漏答案的情况下发生。
同样模式可以迁移到专利之外。TRO 响应里,runner 可以看到法院通知、卖家事实、平台消息和上传证据,而 grader 看到关于辖区、期限、冻结资金、证据缺口和 unsupported legal conclusions 的 rubric。合同审查里,runner 看到合同和谈判目标,grader 看到隐藏 issue checklist 和 reviewer notes。工作框架不绑定专利;专利只是一个好压力测试,因为 recall、source support 和 scope classification 都会出现在交付物里。
分数是信号,不是判决
法律 AI 评测需要数字,但数字不能变成法律结论。
专利 grader 使用 direct coverage、family coverage、source-label recall、high-risk recall、required recall、process score、quality score、risk-analysis score、claim-comparison score 和 legal-scope score 等指标。它还应用 cap:当 case 更宽或 required target recall 很低时,只给 direct-only answer 不能拿很高分;当存在可信专利路径时,NONE 不能默认通过;只有 title match 很弱,除非 trace 比较了产品特征和 claims、abstracts 或 legal status。
这些规则让分数不那么天真。它们仍然不会把系统变成律师。它们帮助判断检索过程是否改善、candidate skill 是否应保留、reviewer 下一步该看哪里。最终法律判断仍然是 review task。
这个区分很重要,因为法律 AI demo 常常把证据质量压缩成回答流畅度。流畅回答可能没有支撑;谨慎回答可能不完整;来源丰富的回答仍可能把风险分类错。工作框架问的是一个更窄、更有用的问题:在受控条件下,这个系统有没有产出更好的复核交付物?
从改 prompt 到维护系统
SDK 把专利循环泛化成一个可复用的 heuristic-learning 工作框架。在 task level,runHeuristicLoop 执行 examples、写交付物、运行 verifiers、计算 split scores,并把 case results 追加到 ledger.jsonl。在 system level,runHeuristicSystemLoop snapshot mutable surfaces,请 maintainer 更新系统,评测 candidate,与 baseline 比较,然后保留改动或恢复 snapshot。
maintainer prompt 被刻意约束。它要求智能体改进可复用 heuristics、tools、rubrics 或交付物协议;保持 validation integrity 和 heldout examples;避免记忆 example-specific answers;并且每轮偏向一个小而可维护的改动。这个约束重要,因为 maintainer 有能力编辑定义未来行为的同一批文件。
system loop 也支持 pairwise preference。有些法律交付物很难用 scalar gate 判断。settlement memo、investor plan 或 customer-facing report 可能需要一个 role-based reviewer 比较 baseline 和 candidate,并说明哪一个更具体、可信或可复核。在这些情况下,candidate 可以通过 pairwise reviewer preference 被保留,而不是只靠 raw score,只要 comparator 本身被配置为工作框架的一部分。
这就是它与 Learning Beyond Gradients 的连接点。法律系统通过软件维护来学习。更新对象包括 instructions、tools、rubrics、交付物 schemas、source policies 和 examples。反馈来自 traces、scores、reviewer notes 和 diffs。记忆存在 ledgers、summaries 和 snapshots 里。循环改进模型周围的系统,而模型权重保持不变。
法律工作里的 train/holdout 问题
holdout cases 在这里不是形式。它们是发现法律 heuristic 过度贴合小样本的唯一办法。
在专利 benchmark 里,一个 training case 可能教系统先搜索 patent markings。如果产品页真的有标记,这是好事;如果新规则让系统在没有标记时停止搜索 assignee 和产品词,那就危险。另一个 training case 可能教系统包含更多 family members。当 benchmark 期待 family recall 时,这是好事;但如果它开始把弱 family context 提升为 HIGH_RISK,就会伤害用户。
SDK 把 split: "train" | "holdout" 当作 example 的一等属性。summary 报告 generalization gap,CLI 可以按 holdout score 选择最佳 candidate。这个实现细节对行为影响很大:工作框架可以偏好一个更能迁移的 candidate,而不是一个刚好赢了训练案例的 candidate。
法律数据集常常很小、私密而混乱。这让 holdout discipline 更重要,而不是更不重要。系统很难拥有大型公开 benchmark 那种统计舒适感,所以需要工程防护,尽早让过拟合可见。
这没有解决什么
这个工作框架没有移除专家审查。它可以说某个 patent-search skill 找回了更多目标专利、bucket 分类更好、claim comparison 更强;它不能决定卖家应该和解、改款、反诉还是忽略通知。
它也不能让 grader 永远正确。智能体 grader 可能误读 trace、奖励冗长推理或不一致地应用 rubric。项目通过混合 deterministic checks、structured reviewer prompts 和 redacted public reports 降低这种风险,但 grader quality 仍然是系统工程的一部分。
循环仍可能过拟合。snapshot/restore 可以阻止坏 candidate 留在 workspace,但不能保证被保留的 candidate 是全局最优。train/holdout split 有帮助,但小型法律数据集仍可能有隐藏相关性。更好的防线是持续增加真正不同的 case,保留未解决失败 taxonomy,并把局部 patch 压缩成更简单规则,避免系统复杂到难以维护。
系统也依赖交付物质量。如果 runner 不写有用 trace,maintainer 很难从失败中学习;如果来源文件缺失,grader 可能只能给最终答案评分;如果 output contract 模糊,bucket metrics 会混在一起。工作框架只有在运行留下足够证据时,才能让失败变得持久。
最后,这不是训练模型。对这个用例来说,这反而是优点。目标是让法律智能体周围的 operational layer 更可靠:检索程序、来源政策、review rubric、trace contract 和 rollback history。模型训练未来也许会使用这些 traces 作为数据,但眼前收益是:系统可以改进,而不把每一次法律失败变成模型内部不可审查的私人记忆。
一个有用的心智模型
对法律 AI 来说,失败应该成为一个有生命周期的对象。
它从一个 case 开始:产品页、通知、合同、投诉、证据包或客户请求。answer-blind runner 产出交付物。grader 事后评分。ledger 记录发生了什么。maintainer 提出可复用更新。snapshot system 保留或恢复改动。train 和 holdout 分数决定这个更新是否足够泛化。未解决 case 留在未来工作里,而不是消失进一次 prompt 修改。
这就是 demo 和可维护系统的区别。demo 只需要回答一次;法律 AI 系统必须记住一次回答为什么失败,避免把答案泄露给下一次测试,并保留撤销自己改进的权利。
参考材料
- lawless-heuristic-sdk/src/loop.ts
- lawless-heuristic-sdk/src/system-loop.ts
- lawless-heuristic-sdk/src/snapshots.ts
- lawless-heuristic-sdk/src/verifiers.ts
- lawless-heuristic-sdk/tests/sdk.test.ts
- Jiayi Weng, Learning Beyond Gradients, 2026.